Arbeit und Orchestrierung
Wie Factories Arbeit abbilden, Agenten koordinieren, deterministische Gates setzen und ihren eigenen Harness verbessern.
Verfasst von
-

Benedikt Stemmildt Gründer & Co-CEO
Aktualisiert:
Software Factories 5
Wie Factories Arbeit abbilden, Agenten koordinieren, deterministische Gates setzen und ihren eigenen Harness verbessern.
Arbeit und Orchestrierung
Ein späteres Gespräch bei Tessl legt fest, wann aus einem Workflow eine Factory wird. Das geschieht, sobald ihr einen Agenten nicht mehr direkt nutzt und Code schreibt, der Agenten arbeiten lässt. Genauer: sobald ihr Arbeit selbst als eigenständige Entität behandelt, als Substanz, die ihr bearbeitet. Arbeit durchläuft drei Sichten. Künftige Arbeit ist öffentlich, und jede:r kann sie übernehmen. Laufende Arbeit liegt in allen Einzelheiten offen, und ihr haltet sie privat. Erledigte Arbeit landet in einem kuratierten Register. Der Tracker Beads formalisiert das als Work Graph aus Git und Datenbank statt als schwergewichtigen Issue Tracker. Die Factory treibt Arbeit in einem festen Rhythmus durch. Sie gibt Token aus, um Arbeit zu erzeugen, indem ein Schwarm Berichte und Bugs anlegt. Danach behebt ein Schwarm sie, ein weiterer reviewt sie, und alles beginnt von vorn.
Bei diesem Tempo lässt sich Arbeit kaum noch zählen. Eine Factory kann dieselbe Aufgabe versehentlich zweimal mit abweichenden Ergebnissen erledigen, und dann muss ein Judge entscheiden. Oder sie verliert einen mit Token bezahlten Run ganz. Jede Factory bekommt deshalb eine dauerhafte Hygieneaufgabe. Eigene Maintainer-Agenten, in Gastown “the dogs”, geben Token aus, damit Skills, Regeln und Maps nicht verrotten. Skills sind die neue Dokumentation und zerfallen bei jeder Nutzung des Systems. Auch die Form der Factory findet ihr stochastisch. Ihr fügt Agenten hinzu, bis ein Dutzend läuft, und merkt dann, dass die Topologie falsch ist. Ihr lasst die Agenten auslaufen, baut Skripte und Verzeichnisse um und startet neu. Erst schneller Auf- und Abbau lässt euch die richtige Form finden. Das Gespräch kommt immer wieder auf dieselbe Antwort. Auf der einen Seite steht eine kleine Crew von Design-Agenten mit tiefem Kontext. Auf der anderen Seite steht Wegwerfarbeit für die Flotte, gut spezifiziert und parallelisierbar (Inside a Software Factory (öffnet in einem neuen Tab), 2026).
Tessls eigene Factory macht die Mechanik greifbar. Zwei Gründungsziele erzwingen schon allein die Form der Factory: kein von Menschen geschriebener Code und keine interaktiven Sessions mit Coding-Agenten. Alles beginnt als Issue in Linear. Ein Orchestrator im Hintergrund fragt Tickets ab, die an den Factory-Agenten delegiert sind. Der Agent übernimmt die Arbeit und öffnet seinen Pull Request selbst, weil das Team ihm einfach die GitHub CLI gibt. Vorher öffnete deterministischer Glue-Code den PR, und das “frequently broke”. Das Team repariert grundsätzlich erst den Harness und korrigiert dann den Agenten. Vor jedem Kommentar im PR muss ein:e Reviewer:in mindestens einmal zurückspulen und etwas am System ändern. Das kann ein geänderter Skill sein, ein neuer Unit-Test oder eine andere Architektur. Dann versucht der Agent es erneut. Erst wenn er es auch beim zweiten Mal nicht in einem Anlauf schafft, darf die Person kommentieren.
Auf dieser Kerneinheit vom Issue zum PR laufen geplante Sweeps außerhalb jedes Diffs:
- Ein Architektur-Agent markiert Duplikate und schwer testbare Nahtstellen.
- Ein Testqualitäts-Agent fährt Coverage und Mutation Testing.
- Dokumentations-Agenten pflegen die Dokumentation.
Mutation Testing findet Randfälle, die Coverage übersieht, etwa eine Liste, die mit 5 und 50 getestet ist, aber nie mit 0. Die Verifikation setzt auf pedantisches, billiges Linting. Eine fünfzigzeilige Regel, die festhält, dass ein Modul nie ein anderes importiert, lohnt sich. Agenten drehen die Architektur nämlich häufig um. Tessl verpackt die LLM-gestützte Variante als “verifiers”, fokussierte semantische Checks wie “every JSX element carries Aria attributes”.
Überraschend ist der Befund zum Determinismus. Tessl begann mit deterministischer Orchestrierung, die Kommentare zwischen den Phasen weiterreichte, und baute fast alles davon wieder aus. Jedes Stück deterministischer Code, das orchestrieren will, wird brüchig, sobald rund 15 Prozent der Features vom angenommenen Muster abweichen. Ein Beispiel dafür waren gestapelte PRs, die der Orchestrator unmöglich gemacht hatte. Determinismus blieb nur an den Enden. Hooks und CI-Gates blockieren einen Commit oder das Ende einer Session, bis die Tests bestehen und die nötigen Skills geladen sind. Die restliche Orchestrierung wanderte in den Task Tracker selbst: Ein Parent-Task mit Blockern ist der Ausführungs-DAG. Das widerspricht nicht der Regel, dass Übergaben zwischen Stufen deterministische Skripte sind, es verfeinert sie. Determinismus gehört an die Gates und in den Glue-Code, nicht in die Mitte eines einzelnen Agenten-Runs (gleiche Quelle).
Aus Sicht der Praxis ist der vollständige Informationspfad die Einheit des Designs, nicht die Schleife allein. Produktive Implementierungen trennen die Instruktionen an Agenten von deterministischem Code. So bleiben jeder Knoten und jede Übergabe prüfbar und austauschbar (FORGET Loop Engineering. Agentic Engineering is about THIS (öffnet in einem neuen Tab), Juli 2026, Praktiker und Kursanbieter).
Automatisierung beginnt erst, wenn ein manueller Durchlauf von Anfang bis Ende die echten Übergaben zeigt. Zeichnet den Pfad auf und automatisiert dann einen Agenten plus einen deterministischen Check. Spezialisierung kommt erst dazu, wenn beobachtete Fehler sie rechtfertigen. So bleibt die erste Implementierung klein genug zum Testen. Wächst die Nebenläufigkeit, bleibt trotzdem Raum für Worktrees oder stärkeres Sandboxing (FORGET Loop Engineering. Agentic Engineering is about THIS (öffnet in einem neuen Tab), Juli 2026, Praktiker und Kursanbieter).
Eine Factory ist außerdem ein geschlossener Regelkreis. Intent und Signale aus der Produktion füllen eine Work Queue. Ein Harness baut die Änderung, und automatische Checks und Review entscheiden, ob sie durchkommt. Telemetrie aus dem Deploy, Incidents und Anfragen speisen den nächsten Zyklus. Intake der Queue und Monitoring der Produktion gehören deshalb zur Orchestrierung der Factory und sind mehr als Infrastruktur drumherum (Software Factories, Light and Dark (öffnet in einem neuen Tab), veröffentlicht am 22. Juli 2026).
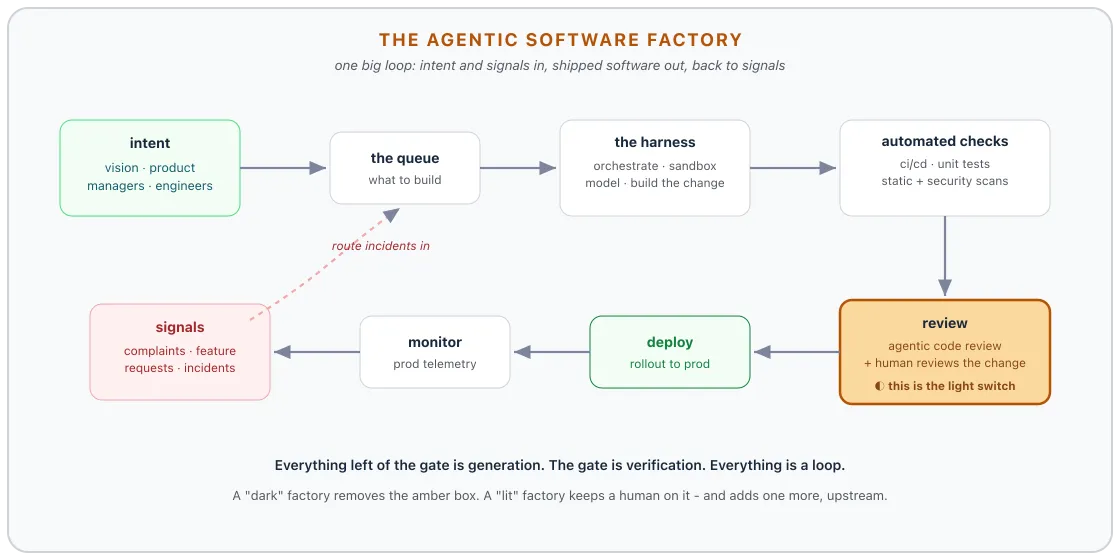
Diagramm aus Software Factories, Light and Dark (öffnet in einem neuen Tab).
Ein Konferenz-Talk des Gründers von Warp geht denselben Kreislauf Stufe für Stufe durch. Intake besteht aus benannten Kanälen: Task Tracker, Chat, Terminal oder IDE und Monitoring. Mit der Triage solltet ihr eine Factory beginnen. Ein einfaches, klares Issue setzt ein Agent direkt um. Ein komplexes gibt er an einen Spec-Agenten weiter. Dieser schreibt eine Produkt-Spec mit den Invarianten des Produkts und eine zweite Spec für Architektur und Form des Codes. Das Review beginnt mit einem Agenten. Die Entscheidung, wo noch ein Mensch reviewt, wird mit der Zeit zur Frage des Risikomanagements. Bei Arbeit, die Nutzer:innen sehen, bedient ein Agent in einer Verifikationsstufe das gebaute Produkt per Computer Use. Dabei nimmt er Videos und Screenshots auf. Danach folgt CI/CD. Eine Monitoring-Stufe gibt zurück an den Intake, was sie in der Produktion sieht (AI Engineer - Software Engineering Is Becoming Factory Engineering (öffnet in einem neuen Tab), September 2026, Talk eines Anbieters).
Derselbe Talk zählt auf, was eine Factory im großen Maßstab braucht. Dazu gehören Intake-Kanäle und eine Control Plane, die die Arbeit verteilt. Die Arbeit läuft in Cloud-Sandboxes, und für jeden Task wählt ihr Agent und Modell. Darunter liegt eine Data Plane, mit der Agenten sich erinnern und besser werden. Der Rat: Baut eine einfache Version selbst. Die skalierte Version kauft ihr besser und steckt die Engineering-Zeit ins Produkt. Verbesserung läuft über Schleifen. In einer Skill-Schleife beobachten Observer-Agenten, wie die Skills der Factory angewendet werden. Korrigiert ein:e Senior Engineer die Kommentare eines Review-Agenten, verbessert ein Observer diesen Agenten für seinen nächsten Run (AI Engineer - Software Engineering Is Becoming Factory Engineering (öffnet in einem neuen Tab), September 2026, Talk eines Anbieters).
In einem späteren Gespräch macht derselbe Gründer die Factory selbst zum Artefakt. Sie ist in Code definiert, so wie Terraform Infrastruktur definiert. Eine Struktur aus Dateien und Ordnern legt die Form der Arbeit fest. Sie bestimmt auch die Agenten, ihre Skills und MCP-Server, wo sie laufen und welche Modelle sie nutzen. Eine Orchestrierungs-Runtime führt diese Definition aus. Weil die Definition Code ist, kann ein Team sie branchen und eine Variante testen. Verbesserungs-Agenten finden Muster in gescheiterten Runs. Ihren Fix schlagen sie als Diff gegen die Definition vor, bis hinunter zu einer ihrer Markdown-Dateien. Jeden aufgezeichneten Task kann ein Team außerdem zum Benchmark machen. So baut es aus echter Arbeit sein eigenes Terminal-Bench oder SWE-bench und zeichnet seine eigene Kurve der Modell-Performance. Als Gefahr nennt das Gespräch Leakage. Ein wiederholter Task kann den fertigen Pull Request oder spätere Commits erreichen. Tasks mit Seiteneffekten öffnen Pull Requests. Jeder neue Lauf braucht deshalb eine saubere Umgebung (Boundary - How to Build an AI Software Factory That Ships Faster (öffnet in einem neuen Tab), Oktober 2026, Praktiker und Anbieter).
Ein Gespräch aus der Praxis zeigt eine Intake-Stufe für Meldungen von Nutzer:innen. Das Team behandelt jede Meldung als nicht vertrauenswürdig. Ein Agent prüft zuerst, ob die neueste Version das Problem schon behebt. Falls ja, sagt er es der meldenden Person. Dann sucht er nach einem Duplikat und versucht, eine klare Reproduktion zu schreiben. Nur eine Reproduktion wird zum Issue. Die Deduplizierung bleibt erwartbar unvollkommen und lohnt sich trotzdem, wenn sie die Hälfte findet. Jede Reproduktion läuft danach bei jedem Pull Request mit. Das ist billig, weil die meisten nur CPU-Zeit brauchen. So weiß das Team jederzeit, ob ein Issue behoben ist. Manche Meldungen lassen sich nicht reproduzieren oder hängen von externen Daten ab. Sie gehen per Chat an einen benannten Menschen, mit der Reproduktion oder einem Plan im Anhang. Ein Agent stuft außerdem die Schwierigkeit jedes Issues ein. Er wird gegen eine Datenbank vergangener Issues evaluiert. Das Team hoffte auf mindestens 60 Prozent Genauigkeit und korrigiert über die Größe des Diffs. Wächst ein als klein eingestufter Fix auf Hunderte Zeilen, stuft das Team ihn neu ein. Die Vertrauensgrenze prägt auch die Infrastruktur. Ausgeführt werden nur Reproduktionen, die Agenten geschrieben haben, rohes Feedback nie. Deshalb laufen diese Agenten ohne Sandbox auf den eigenen Maschinen des Teams (Boundary - How to Build a Software Factory for AI Coding Agents (öffnet in einem neuen Tab), August 2026, Praktiker und Anbieter).
Der Bericht über die Dark Factory treibt das Muster bis zum autonomen Endzustand. Nützlich ist sein Katalog der Fehlerbilder:
- Wer jeden Agenten von Hand steuert, der “circus ringmaster”, betreibt einen manuellen Prozess mit agentischer Fassade.
- Wer wiederkehrende Fehler von Hand behebt, statt den Fix zu kodifizieren, der “mechanic”, kommt nie voran.
- Produktionsvolumen ohne reife Infrastruktur zur Validierung ergibt eine “bullshit factory”. Agenten optimieren darauf, die vorhandenen Gates zu bestehen, und schwache Gates bestehen sie leicht.
Das konstruktive Gegenstück ist die Automatisierungs-Ratsche. Jede menschliche Fehlerkorrektur wird sofort als Fitness Function, Testszenario oder Agentenregel kodifiziert. So ist der Fix zugleich ein Upgrade des Systems (Dark Factory Patterns).
Quellen
Arbeit und Orchestrierung
- FORGET Loop Engineering. Agentic Engineering is about THIS (öffnet in einem neuen Tab) - Leitfaden aus der Praxis: vollständige Ausführungspfade abbilden, das Urteil des Agenten von Code trennen und schrittweise automatisieren.
- Software Engineering Is Becoming Factory Engineering (öffnet in einem neuen Tab) - Konferenz-Talk des Gründers eines Anbieters von Terminal-Agenten. Er geht eine Software Factory Stufe für Stufe durch, von der Triage über das Monitoring bis zu Schleifen, die Skills verbessern.