Software Factories in Produktion: Belege
Berichtete Software Factories erreichen hohen autonomen Durchsatz dort, wo Spezifikationen, Tests und Umgebungen schon vor den Agenten stark waren. Die meisten Zahlen sind Selbstauskünfte von Anbietern oder Frontier Labs. Kosten, Review-Kapazität und langfristige Wartbarkeit bleiben die harten Grenzen.
Verfasst von
-

Benedikt Stemmildt Gründer & Co-CEO
Aktualisiert:
Software Factories 5
Unsere Position. Wir lesen die Zahlen einer Factory danach, was in Produktion ankommt und was dort bricht. Diese Metriken tragen auch dann noch, wenn automatisierte Gates das manuelle Review ersetzen (AI measurement framework (öffnet in einem neuen Tab)). Produktivität ist nicht Wert: KI bläht alles auf, was sich leicht messen lässt, etwa Codemenge, Zahl der Pull Requests und Velocity. Auf den Wert wirkt sie neutral (The productivity lie (öffnet in einem neuen Tab)).
Die meisten berichteten Deployments zählen Pull Requests und Codezeilen. Deshalb beantworten nur wenige diese Frage. Am deutlichsten scheitern Factories dort, wo niemand den Code liest, den die Agenten schreiben.
Was zeigen Factory-Deployments?
- Die meisten öffentlichen Beispiele zählen Pull Requests, Codezeilen und Autonomieraten. PFF gehört zu den wenigen, die einen Qualitätswert aus Kundensicht berichten.
- Die Fehlschläge häufen sich dort, wo das Review aufgehört hat. Agenten imitieren die Muster, die sie vorfinden. So wird jede schlampige Änderung, die gemergt wird, zur Vorlage für die nächsten.
Welche Deployments berichten Zahlen?
Inzwischen gibt es konkrete Fälle ganz ohne von Menschen geschriebenen Code, an denen sich die Größenordnung des Musters ablesen lässt. Das Codex-Team von OpenAI hat ein internes Produkt gebaut und ausgeliefert, ohne eine einzige Zeile von Hand zu schreiben. In fünf Monaten entstanden rund eine Million Zeilen und 1500 gemergte PRs, das sind 3,5 PRs pro Engineer und Tag. Bezeichnend: Der Durchsatz stieg, als das Team von drei auf sieben Engineers wuchs, statt zu sinken (Harness Engineering (öffnet in einem neuen Tab), OpenAI).
Ona hat im öffentlichen Memo-Experiment in zehn Tagen 375 gemergte PRs, 67.000 Zeilen und 1067 Tests ausgeliefert, bei einer Autonomierate von 87 Prozent. Vom Issue bis zum Schließen vergingen im Median 38 Minuten, vom PR bis zum Merge 4,9 Minuten. Gesteuert wurde das von 16 verketteten Automationen. Die dokumentierte Lehre: Die Qualität der Spec ist die Stellschraube. Die meisten Bugs waren Fehler der Spezifikation, nicht der Fähigkeiten, und ein Tag Spec-Schreiben spart eine Woche Bugfixing (Ona – We Built a Software Factory in 10 Days (öffnet in einem neuen Tab), 30. April 2026).
Im September 2026 betreibt OpenAI das Muster in seiner gesamten Engineering-Organisation. Ein Besuch vor Ort beschreibt es als Schleife aus neun Schritten. Ein menschlicher Builder, ein Engineer oder ein Product Manager, legt das Ergebnis fest. Laut der Infrastruktur-Leitung von OpenAI arbeiten die Engineers dadurch eher wie Product Manager als wie Systems Engineers, denn Urteilsvermögen, Priorisierung und Geschmack entscheiden diesen Schritt. Danach sammelt Codex Kontext aus den Repositories, aus Slack und Notion, aus internen Datenquellen wie Databricks und Datadog und aus internen Skills, von denen Codex einige selbst pflegt. OpenAI hat seine gesamte Dokumentation in den Quellcode verlegt, damit Agenten sie lesen können. Neue Engineers sollen ihre Onboarding-Fragen an Codex richten.
Der Agent implementiert die Änderung, baut und testet sie, öffnet den Pull Request und behebt CI-Fehler, bis der Build grün ist. Ein Perf-Harness schickt verdächtige Änderungen an ein A/B-Performance-Framework. Spezialisierte Review-Agenten und ein Risiko-Check entscheiden über den Weg in Produktion, und ein Deploy-Agent begleitet die Änderung bis dorthin. Zwei Agenten speisen den Betrieb zurück in die Entwicklung: Perf Factory für Latenz-Regressionen und Sevbot für Incidents (The Pragmatic Engineer - Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab), September 2026). Das interne Codex ist an fast jedes System im Unternehmen angebunden und dem öffentlichen Produkt weit voraus. Das Setup gehört also einem Frontier Lab mit unbegrenztem Token-Budget und lässt sich so nicht übertragen (The Pragmatic Engineer - Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab), September 2026).
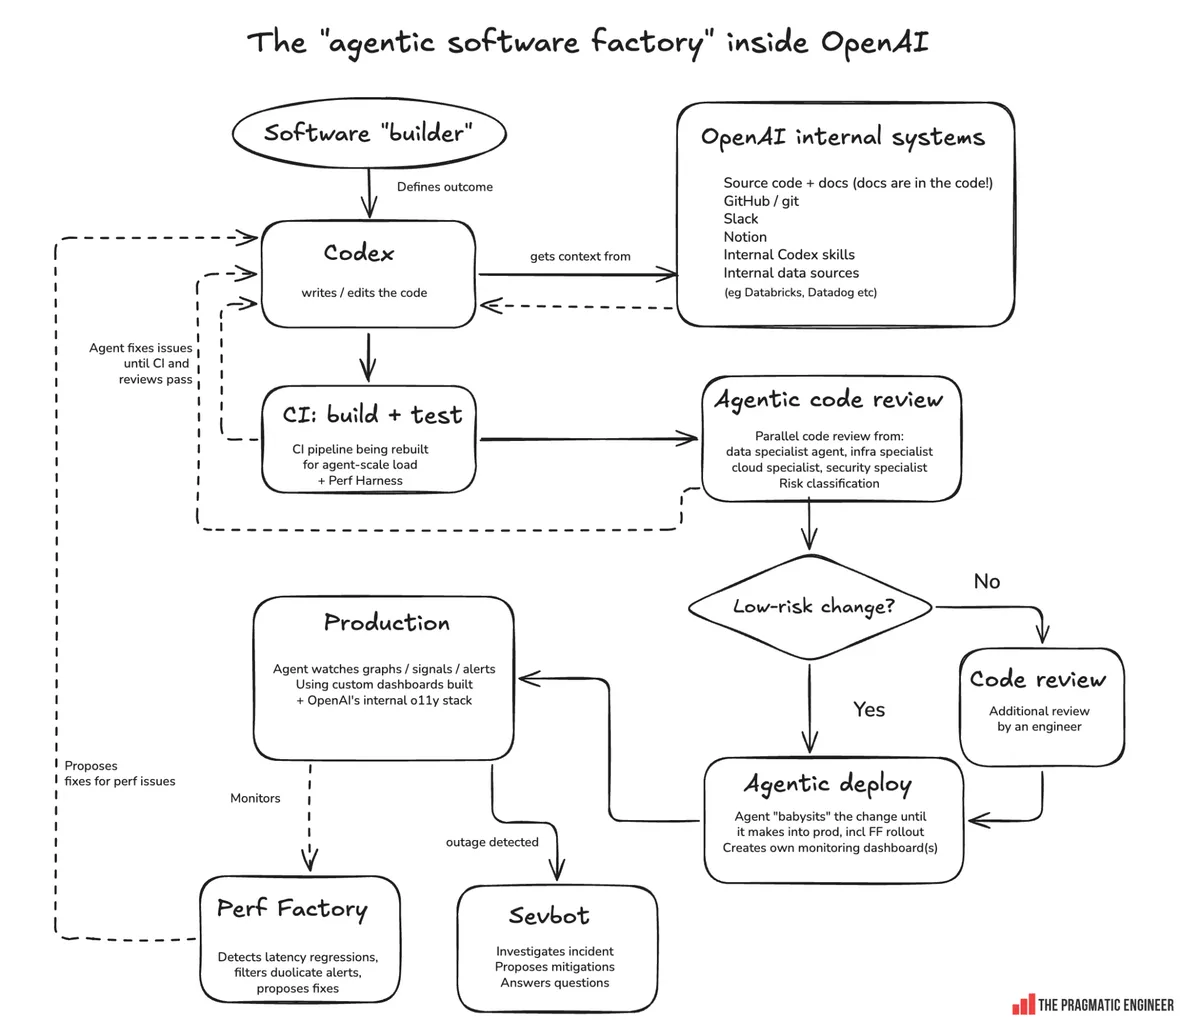
Abbildung 1. Jede Änderung durchläuft vor dem Deploy CI, spezialisierte Review-Agenten und einen Risiko-Check. Produktions-Monitore speisen Regressionen und Incidents über die gestrichelten Pfade zurück in Codex. Abbildung aus The Pragmatic Engineer - Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab).
Derselbe Bericht misst, wohin sich der Engpass verschoben hat. Die Pull Requests pro Engineer wachsen immer schneller, und manche Build-, Test- und Deploy-Systeme tragen etwa das Zehnfache ihrer früheren Last. Die Infrastruktur-Leitung veranschlagt dieses Wachstum für die meisten Unternehmen auf zwei bis drei Jahre, für OpenAI auf etwa sechs Monate. Jede neue Welle an Modellfähigkeit legt den nächsten Bottleneck frei, in der Versionskontrolle, in CI/CD oder im Release. Der Engineering-Lead für ChatGPT nennt native Mobile-Apps als einen, der zunehmend schmerzt. Jedes App-Update wartet Stunden bis Tage auf das Review von Apple und Google. Code, den ein Agent in Minuten schreibt, kommt so trotzdem langsam heraus, und Web und Mobile driften in der Liefergeschwindigkeit auseinander (The Pragmatic Engineer - Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab), September 2026). Die IDE-Nutzung bei OpenAI ist seit Januar 2026 gesunken, als die Codex-Nutzung sprunghaft stieg. Genau darauf hatte das Codex-Team gewettet, als es für seine Desktop-App VS Code nicht forkte (The Pragmatic Engineer - Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab), September 2026).
Dieselbe Verschiebung zeigt sich im Kleinen. Ein Ona-Build verbrachte 30 Minuten mit der Spec und 10 mit der Ausführung. Die ursprüngliche Spec blieb die saubere Quelle der Absicht, eine separate Iterations-Spec protokollierte jedes Problem und jeden Fix. Das Prinzip dahinter: Der Bottleneck liegt nicht mehr beim Schreiben von Code, sondern bei der Entscheidung, was gebaut wird (Spec-Driven Design: Why Planning Is the New Coding (öffnet in einem neuen Tab), 25. März 2026). Derselbe Lauf zeigt auch die Grenzen der Factory. Sie konnte Anforderungen erfüllen, driftete aber zu einer generischen KI-Standardästhetik und entwickelte nie von sich aus Geschmack. Deshalb blieben menschliche Stunden nötig. Anfangs waren es 8 bis 10 pro Tag für den Bau des Harness aus AGENTS.md, architecture.md, design.md, conventions.md und einer benoteten quality.md. Sobald die Maschine stand, sanken sie auf 2 bis 3 pro Tag für Metriken, Review und Produktrichtung (Ona – Building a Software Factory: Week 1 (öffnet in einem neuen Tab), 21. April 2026).
Every berichtet, mit 15 Leuten vier Produkte zu betreiben, wobei Agenten rund 99 Prozent des Codes schreiben. Every argumentiert, dass der Hebel bei voller Adoption sprunghaft wächst: Zwischen einer Organisation, in der 90 Prozent der Engineers KI nutzen, und einer, in der alle es tun, liege ein Faktor 10 (Every – Compounding Engineering talk (öffnet in einem neuen Tab), 18. Dezember 2025).
Ein Konferenz-Talk eines mittelgroßen Unternehmens berichtet eigene Zahlen zu derselben Form. Sie stammen aus dem Vergleich zweier Teams, nicht aus einer kontrollierten Studie. Das Sportdaten-Unternehmen PFF ließ von Januar bis März zwei seiner stärksten Engineers in einem Agents-first-Workflow gegen ein Team von rund zehn Engineers antreten. Gemessen wurden:
- 25-fache Deploy-Frequenz (fünf pro Tag statt einem alle fünf Tage),
- zehnfacher Output, gemessen als Mischung aus Ticketzahl und Codekomplexität,
- Features in unter zwei Monaten statt der geschätzten vier,
- ein Kunden-Qualitätswert von 8,6 von 10 statt vorher rund 7 bis 7,5.
Der Befund zum Prozess: “Scrum did not survive”. Es gab keinen PM, keine Sprintplanung, keine Standups (Tickets aktualisieren sich aus dem PR-Status) und keine Schätzungen. An ihre Stelle trat ein Ablauf von der Spec zu einem schlanken Designdokument, in dem der Agent die anfragende Person interviewt. Dazu kamen automatisch angelegte, nicht blockierende Tickets und ein QA-Agent, der bei jedem Staging-Deploy die Akzeptanzkriterien prüft (PFF agents-first case study talk (öffnet in einem neuen Tab), 15. Mai 2026).
Blitzy berichtet, dnsmasq in drei Tagen autonom von C nach Rust umgeschrieben zu haben (86.000 Zeilen, 592 bestandene Tests, null Kompilierfehler). Für curl (215.000 Zeilen, 7312 Tests, sauber unter Miri und AddressSanitizer) brauchte es fünf Tage. Das menschliche Gate liegt bei der Freigabe der technischen Spezifikation, nicht beim Code-Review. Blitzy liefert etwa 80 Prozent eines Projekts, die letzten 20 stellen Menschen fertig (Blitzy – C to Rust: curl (öffnet in einem neuen Tab), Anbieterangabe). Auf derselben Plattform brachte ein:e Designer:in ohne Programmierkenntnisse einen Blog von Figma-Frames bis zum Produktions-Deploy (Blitzy – How Blitzy Built This Blog (öffnet in einem neuen Tab)).
Blitzy hat außerdem aus einem leeren Repository einen C-Compiler gebaut: 229.983 Zeilen Rust, 2271 Tests, vier Backends, keine externen Abhängigkeiten, und der Linux-Kernel bootet unter QEMU. Vorher reparierte Blitzy den agentengebauten Compiler von Anthropic. Dessen öffentliches Release kompilierte zwar den Linux-Kernel, startete aber mit einem Issue “hello world does not compile” und 14 Fehlkompilierungen, die ein externer Fuzzer fand. Das zeigt die Lücke zwischen einer bestandenen Testsuite und Produktionssoftware (Blitzy – Hello World! The Blitzy C Compiler Has Arrived (öffnet in einem neuen Tab), Anbieterangabe).
Blitzy deutet sein Benchmark-Ergebnis direkt: Ein Rekord von 66,5 Prozent auf dem auditierten öffentlichen Set von SWE-Bench Pro (gegenüber 57,7 für GPT 5.4 und 55,4 für Claude Code Opus 4.5) belege, dass Fortschritte auf der Harness-Ebene inzwischen größere Gewinne freisetzen als das Modell. Der Grund laut Blitzy: Es verbringt Stunden damit, einen Knowledge Graph der gesamten Codebasis aufzubauen, und trifft dadurch die Randbedingungen, die ein Modell in einem einzigen Durchlauf verfehlt (Blitzy – Blitzy Scores a Record 66.5% on SWE-Bench Pro (öffnet in einem neuen Tab), Anbieterangabe).
Hinter diesen Läufen steht Blitzys strategische These, dass sich Autonomie nicht nachträglich auf einen Assistenten setzen lässt. Verstehen und Orchestrierung müssen von Tag null an verschmolzen sein. Derselbe Graph, der einen Agenten in einer Datei verankert, halte auch tausend Agenten in einem Repository mit einer Million Dateien kohärent: “the graph that grounds a single agent in a single file is the same graph that lets a thousand agents maintain coherence across a million-file repository”. Als Belege aus dem Enterprise-Umfeld nennt Blitzy:
- mehr als eine Milliarde Zeilen Code, eingelesen seit September 2025,
- ein Reverse Engineering von 33 Millionen Zeilen Mainframe-Code für ein Fortune-100-Unternehmen in 3,5 Tagen, bei geschätzten neun Monaten für ein eigens dafür abgestelltes Team,
- nach eigener Aussage 2,91 Dollar ARR je verbranntem Dollar seit Januar 2025.
Die Folgerung: Sobald Engineering nicht mehr der Bottleneck ist, “the question stops being ‘can we build this?’ and starts being ‘what should we build?’” (Blitzy – Taking the Long and Less Traveled Road Is the Only Path to Autonomy (öffnet in einem neuen Tab), Anbieterangabe).
Wirtschaftlich führt Blitzy dasselbe Stranded-Capital-Argument ins Feld, nur auf Projektebene. Ein Memory-Safety-Rewrite wie zlib nach Rust rechnet sich normalerweise nicht: Rust-Talente sind knapp, die Velocity fällt in den ersten Monaten um 30 bis 50 Prozent, und nur 15 Prozent der Enterprise-Migrationen werden pünktlich fertig. Eine Factory, die diese Monate zusammenschiebt, macht laut Blitzy die “SaaSpocalypse” plausibel: Unzufriedene Kund:innen holen Legacy-ERP und SaaS als Eigenentwicklung ins Haus. Zum Vergleich: Laut Gartner verfehlen 70 Prozent der ERP-Migrationen ihre ursprünglichen Ziele (Blitzy – Harbinger of the SaaSpocalypse (öffnet in einem neuen Tab), Anbieterangabe).
Augment Code beschreibt die organisatorische Antwort als Cosmos, ein Betriebssystem auf Organisationsebene, das Menschen, Agenten, Code, Tools, Policies und Gedächtnis in einer Umgebung koordiniert (Selbstauskunft des Anbieters).
Was kostet der Betrieb einer Factory?
Die Kostenseite wird in Einheiten beziffert. StrongDM nennt als Faustregel, dass eine Factory mit Spielraum mindestens 1000 Dollar an Tokens pro Engineer und Tag ausgibt (StrongDM - Software Factory (öffnet in einem neuen Tab)). Im Februar 2026 behauptete ein Praxisbericht, die Gesamtkosten der Softwareentwicklung seien auf etwa 10,42 Dollar pro Stunde gefallen, also unter den Mindestlohn (Software Development Now Costs Less Than Minimum Wage (öffnet in einem neuen Tab), 27. Februar 2026).
Die Kostenbasis ist zugleich ein Abhängigkeitsrisiko. Die Frontier Labs steuern auf die Prüfung durch den Kapitalmarkt zu, deshalb werden sich Preise, Pakete, Kontingente und Nutzungsbeschränkungen weiter ändern. Die Absicherung der Factory ist hybrides Model Routing: teure Frontier-Modelle für Planung und schwieriges Reasoning, günstigere oder lokale Modelle für Routineausführung, Review, Klassifikation und mechanische Arbeit (What’s the Appeal of a Software Factory? (öffnet in einem neuen Tab)).
An der Review-Naht läuft dieselbe Routing-Logik in die Gegenrichtung. Modelle urteilen besser, als sie generieren. Ein Code-Review- oder Validierungsdurchgang kann deshalb eine ganze Fähigkeitsklasse unter dem Generator liegen und trotzdem halten. Die Factory ist zum Teil genau das, was billige Modelle niedriger Stufe in der Spur hält. Die dauerhafte Praxis: Jede Arbeitseinheit bekommt eine Intelligenzstufe und geht an das günstigste Modell, das sie schafft. Frontier-Modelle bleiben dem Planen vorbehalten und dem Auftrag, die Flotte in der Spur zu halten (Inside a Software Factory (öffnet in einem neuen Tab), 6. Juli 2026).
Wo scheitert Lights-off-Autonomie?
Ein Praxisbericht zieht dieser Autonomie eine konkrete Grenze. Ein Lights-off-Experiment im Juli 2025 lief, bis ein Issue verlangte, eine Codebasis zu verstehen, die niemand mehr gelesen hatte. Danach war die Seite down, und der Mensch musste zurück in den Code. Die Erklärung ist strukturell. Das Training von Coding-Agenten belohnt bestandene Tests, für Architektur oder Wartbarkeit fehlt ein vergleichbares Signal. Deren Kosten zeigen sich erst Monate später. Heutige Benchmarks können deshalb nicht belegen, dass ein Modell eine Codebasis über die Zeit intakt hält (Harness engineering is not enough: Why software factories fail (öffnet in einem neuen Tab), Juli 2026).
Die vorgeschlagene Antwort: menschliches Review behalten und vor der Implementierung eine kurze Abstimmungsphase einlegen, zu Produktabsicht, Systemarchitektur, Typen, Call Graphs und Vertical Slices. Laut Talk können rund 30 Minuten Planung Stunden an Review sparen. Das bleibt aber eine Aussage aus der Praxis, kein kontrollierter Beleg (Harness engineering is not enough: Why software factories fail (öffnet in einem neuen Tab), Juli 2026). Die schriftliche Fassung beziffert den Tausch ausdrücklich. Den Workflow mit Review bietet sie als 2- bis 3-fachen Gewinn an, gegenüber dem 10- bis 100-Fachen, das der Lights-off-Ansatz verspricht und bisher nicht geliefert hat. An dieser ehrlichen Zahl sollte sich ein Business Case für eine Factory messen lassen (Why Software Factories Fail (öffnet in einem neuen Tab), Juli 2026).
Ein späteres Interview derselben Quelle ergänzt, warum übersprungenes Review sich aufschaukelt. Agenten imitieren die Muster, die sie in der Codebasis finden. Jede schlampige Änderung, die gemergt wird, wird so zur Vorlage für die nächsten. Beide Seiten des Gesprächs halten das gegen die Ansicht, technische Schulden seien billig zu tragen, weil Agenten sie später abbauen. Das gälte nur, wenn jede Änderung entstünde, ohne bestehenden Code zu lesen (AI Native Dev - Why We Stopped Trusting AI to Write the Plan (öffnet in einem neuen Tab), September 2026, Praxis und Anbieter).
Der fehlende Benchmark bekam im März 2026 eine erste Messung. SlopCodeBench lässt einen Agenten seine eigene frühere Lösung über 196 Checkpoints in 36 Aufgaben erweitern. In der Revision vom Mai 2026 löste kein Agent eine Aufgabe vollständig, der beste bestand 14,8 Prozent der Checkpoints. Die strukturelle Erosion stieg in 77 Prozent der Verläufe, die Verbosität in 75,5 Prozent. Am Ende war der Agentencode 2,3-mal so wortreich und 2,0-mal so erodiert wie 473 Open-Source-Repositories in Python. Explizite Qualitätsvorgaben senkten das Ausgangsniveau um bis zu ein Drittel, bremsten den Verfall aber nicht (SlopCodeBench: Benchmarking How Coding Agents Degrade Over Long-Horizon Iterative Tasks (öffnet in einem neuen Tab), März 2026, überarbeitet im Mai 2026).
Was messen selbst mergende und orchestrierte Builds?
Ein Unternehmen mit fünf Personen berichtet vom selbst mergenden Ende des Spektrums. Agenten schreiben jede Zeile, CI-Gates und KI-Review-Bots laufen auf jedem Pull Request, und eine Änderung, die beides besteht, merged sich selbst. Blockiert ein Reviewer, pusht der Agent eigene Fixes. Merge ist nicht Release: Eine separate User-Acceptance-Suite fängt täglich Regressionen ab und blockiert jedes Release, bis sie behoben sind. Das Repository sagt dem Agenten, dass die Tests die Quelle der Wahrheit sind und nicht geändert werden dürfen.
In 30 Tagen wurden 217 Issues ausgeliefert und 81 als Duplikat oder abgelehnt geschlossen. Bis zur Triage vergingen im Median 4,6 Stunden Durchlaufzeit, von der Triage bis zur Auslieferung vergingen 1,6. Die Kosten lagen bei etwa 3000 Dollar im Monat für fünf Abos plus den Ausgaben für CI-Reviews. Alle Zahlen sind Selbstauskünfte des Sprechers aus einem Konferenz-Talk (AI Native Dev - GitHub Next & Tessl on the Self-Merging Repo (öffnet in einem neuen Tab), September 2026, Praxis).
Factory hat die vollständige Bilanz eines orchestrierten Builds veröffentlicht: ein Slack-Klon mit Channels, Threads, Reactions, Datei-Uploads, Suche und Präsenzanzeige. Die Mission lief 16,5 Stunden über sechs Meilensteine. Auf die Orchestrierung entfielen 2,3 % der Zeit, auf die Implementierung 60,5 % und auf die Validierung 37,2 %. Ein Orchestrator, 63 Worker-Läufe und 27 Validator-Läufe verbrauchten 778,5 Mio. Tokens, davon 744,9 Mio. Cache-Reads. Heraus kamen 38.800 Codezeilen, 52,5 % davon Tests, bei 89,25 % Statement Coverage.
Die Validatoren fanden 81 Probleme. Der Orchestrator antwortete darauf mit 21 Fix-Features zusätzlich zu den 40 ursprünglichen, deshalb brauchten die Meilensteine zwei bis vier Validierungsrunden. Im Median blieben die Läufe bei 51 Assistant-Turns für die Implementierung und 30 für die Validierung. Die Worker teilten ihren Zustand über Dateien, darunter ein Validierungsvertrag, eine Feature-Liste, eine Services-Datei und AGENTS.md (Factory - How Missions Work (öffnet in einem neuen Tab), April 2026, Anbieterangabe).
Verwandte Seiten
- Das Software-Factory-Pattern: das Muster, das diese Deployments umsetzen, und wie man es misst.
- Rollen und Wirtschaftlichkeit der Software Factory: als was eine ausgelieferte Änderung zählen sollte und was sie kosten darf.
- Dark Factory Patterns: die Muster hinter den Lights-off-Läufen und ihre Anti-Patterns.
- KI-Produktivitätsstudien: METR, Stanford, DORA, Multitudes: unabhängige Studien, an denen sich die Selbstauskünfte der Anbieter messen lassen.
- Qualitäts- und Produktivitätsmetriken: die Maße, die tragen, wenn Volumenmetriken in die Irre führen.
Quellen
Belege aus Factories
- GitHub Next & Tessl on the Self-Merging Repo (öffnet in einem neuen Tab) - Zusammenschnitt einer Konferenz mit selbst berichteten 30-Tage-Zahlen eines Fünf-Personen-Teams, dessen Pull Requests sich hinter CI-Gates selbst mergen.
- Harness engineering is not enough: Why software factories fail (öffnet in einem neuen Tab) - Englischsprachiger Praxis-Talk: Harnesses, die auf bestandene Tests setzen, können langfristige Wartbarkeit noch nicht prüfen, und Design vorab hält menschliches Review machbar.
- How Missions Work (öffnet in einem neuen Tab) - Factorys Bilanz zu Kosten, Zeit und Validierung für einen Multi-Agenten-Build eines Slack-Klons über 16,5 Stunden.
- Inside OpenAI’s agentic software factory (öffnet in einem neuen Tab) - Englischsprachiger Newsletter-Artikel, drei von sieben Abschnitten frei, zeichnet OpenAIs mit Codex gebaute Lieferschleife vom Ergebnis bis zur Incident-Reaktion nach.
- Why We Stopped Trusting AI to Write the Plan (öffnet in einem neuen Tab) - Englischsprachiges Interview: Menschliches Code-Review bleibt nötig, weil Agenten gemergten Slop kopieren und es für Wartbarkeit keinen schnellen Test gibt.