Spec-driven Development
Wie Spezifikationen Coding-Agents eine stabile Absicht und überprüfbare Arbeit geben.
Verfasst von
-

Benedikt Stemmildt Gründer & Co-CEO
Aktualisiert:
Agentic Engineering 5
Wie Spezifikationen Coding-Agents eine stabile Absicht und überprüfbare Arbeit geben.
Spec-driven Development
Wenn Agenten die Syntax schreiben, wandert das wichtigste Artefakt des Menschen vom Code zur Absicht. Ihr beginnt mit einer Absicht und schärft sie mit dem Agenten im Plan Mode. Aus diesem Gespräch entsteht eine präzise Spezifikation. Sie, nicht der Quellcode, ist das dauerhafte Asset, das über jede Ausführungsschleife hinweg trägt. Eine Spezifikation enthält zweierlei: Schemas, die die Form der Daten festlegen (OpenAPI, GraphQL, Prisma, JSON Schema), und Geschäftsregeln, die das Verhalten tragen. LLMs erfüllen ein starres YAML- oder JSON-Schema weit besser als einen Absatz in natürlicher Sprache. Die Struktur legt Feldnamen, Typen und Statuscodes fest und lässt fast nichts zu interpretieren.
Sicher bleibt das mit dem Plan-Build-Verify-Zyklus. Ihr schärft die Spec mit dem Agenten im Plan Mode. Dann erlaubt ihr dem Agenten, gegen den freigegebenen Plan zu bauen. Zuletzt prüft ihr das Ergebnis mit automatisierten Contract- oder Schema-Tests statt mit bloßem Auge. Der entscheidende Vorbehalt: Schemas begrenzen Form und Typen, nicht Verhalten. Ein OpenAPI-Schema kann sagen, dass /register ein 201 zurückgibt. Dass eine doppelte E-Mail-Adresse vor dem Schreiben in die Datenbank scheitern muss, kann es nicht sagen. Verhalten steckt in Akzeptanzkriterien, ADRs und vor allem in Tests. Bestandene Contract-Tests belegen also die Form, nie die Logik. Aus demselben Grund scheitert natürliche Sprache im großen Maßstab. Englisch ist mehrdeutig, Prompts verschlechtern sich über Modellversionen hinweg, und gegen einen englischen Absatz lässt sich kein automatisierter Test schreiben. Ein typisiertes Schema dagegen schränkt einen Agenten gleichbleibend ein, auch wenn das Modell darunter wechselt.
Spec-driven Development (SDD) wird zum Standard für nicht-triviale agentische Arbeit und löst das Iterieren nach dem Muster Prompt-and-Pray ab. Der Urheber des Begriffs “vibe coding” erklärte ein Jahr später, diese Ära gehe zu Ende, zugunsten von “agentic engineering”. Gemeint ist, Agenten gegen detaillierte Spezifikationen zu orchestrieren, unter menschlicher Aufsicht. In der Praxis beginnt der Workflow mit einer Projekt-Constitution (Mission, Tech-Stack, Roadmap). Danach läuft pro Feature eine Schleife aus Planen, Implementieren und Validieren, mit bewussten Phasen der Neuplanung dazwischen. Robust wird das durch eine Disziplin: Korrekturen laufen über die Spec, statt Code im Chat zu flicken. So bleibt die Spezifikation über Sitzungen und Agenten hinweg die gemeinsame Quelle der Absicht (Towards Data Science - From Vibe Coding to Spec-Driven Development (öffnet in einem neuen Tab)).
Oft beginnt die Disziplin einen Schritt früher, bei den Anforderungen statt beim Plan. Ein Requirements-Analyst-Agent mit einer einzigen Aufgabe entsteht selbst aus einem einzigen Satz Instruktion. Er interviewt euch durch Discovery-Phasen und erzeugt eine REQUIREMENTS.md. Sie legt das Was und das Warum fest, nie das Wie. Danach übergibt er an einen Solution Architect, einen Developer und einen Reviewer, jeder in seinem eigenen Kontext. Unausgesprochene Annahmen vorab zu benennen ist der Schritt, der Wochen späterer Korrektur spart. Zwei Wochen Programmieren holen fünf Minuten Nachdenken eben nicht zurück (Requirements Analyst Agent (öffnet in einem neuen Tab), 2026). Eine aufgeschriebene Spec bringt außerdem die Menschen untereinander auf eine Linie, nicht bloß den Agenten. Auch deshalb sind Spezifikationen politisch (Four Patterns of AI-Native Development (öffnet in einem neuen Tab), 2025).
McKinsey beschreibt denselben Schritt auf Ebene der Organisation. Die Arbeitseinheit wechselt von story-driven zu spec-driven. Product Manager:innen iterieren mit Agenten an Specs, statt lange PRDs zu schreiben (McKinsey - The AI Software Development Operating Model (öffnet in einem neuen Tab), 2026).
Ein Playbook eines Anbieters zieht dieselbe Kette von Artefakten über die Spec hinaus durch den ganzen Lebenszyklus. Seine Prämisse: Sobald Code nicht mehr der Bottleneck ist, wandert die Engstelle zu den Stufen vor und nach dem Build. Planung, Review und Deploy laufen weiter in menschlichem Tempo. Die Kontrollen dort werden dann unbeherrschbar statt bloß langsam. Jede Zeile von Hand zu prüfen ergab Sinn, solange ein Mensch sie schrieb. Die vorgeschlagene Antwort: Jede Stufe endet mit dem Commit eines Artefakts, das die nächste Stufe liest. Den Anfang macht eine intent.md, die der:die Auftraggeber:in in eigenen Worten schreibt. Die Product Owner:in korrigiert sie, bevor sie committet wird. Darauf folgt eine spec.md, die Anforderungen und Design in einer Arbeitssitzung zusammenführt, gegen Skills mit den Standards der Organisation. Im Plan Mode entsteht eine plan.md. Danach kommen der Diff mit seinen Tests und der Pull Request mit seinen Review-Befunden. Die Kette der Commits ist selbst der Audit-Trail: wer was angefragt hat, was der Agent geliefert hat und wer es freigegeben hat. Compliance braucht deshalb keinen eigenen Nachweis. Dieselben Commits sind zugleich die Auslöser. Eine akzeptierte intent.md startet den Design-Durchlauf, eine freigegebene spec.md startet den Plan Mode. Eine Anomalie in Produktion schreibt die nächste intent.md (Anthropic - The AI-Native SDLC Playbook (öffnet in einem neuen Tab), August 2026, Anbieter). Lest das als Selbstbeschreibung des Anbieters über seine eigene Applied-AI-Praxis. Übertragbar sind ein committetes Artefakt pro Stufe und die Übergabe, die am Commit hängt, nicht die konkreten Dateinamen.
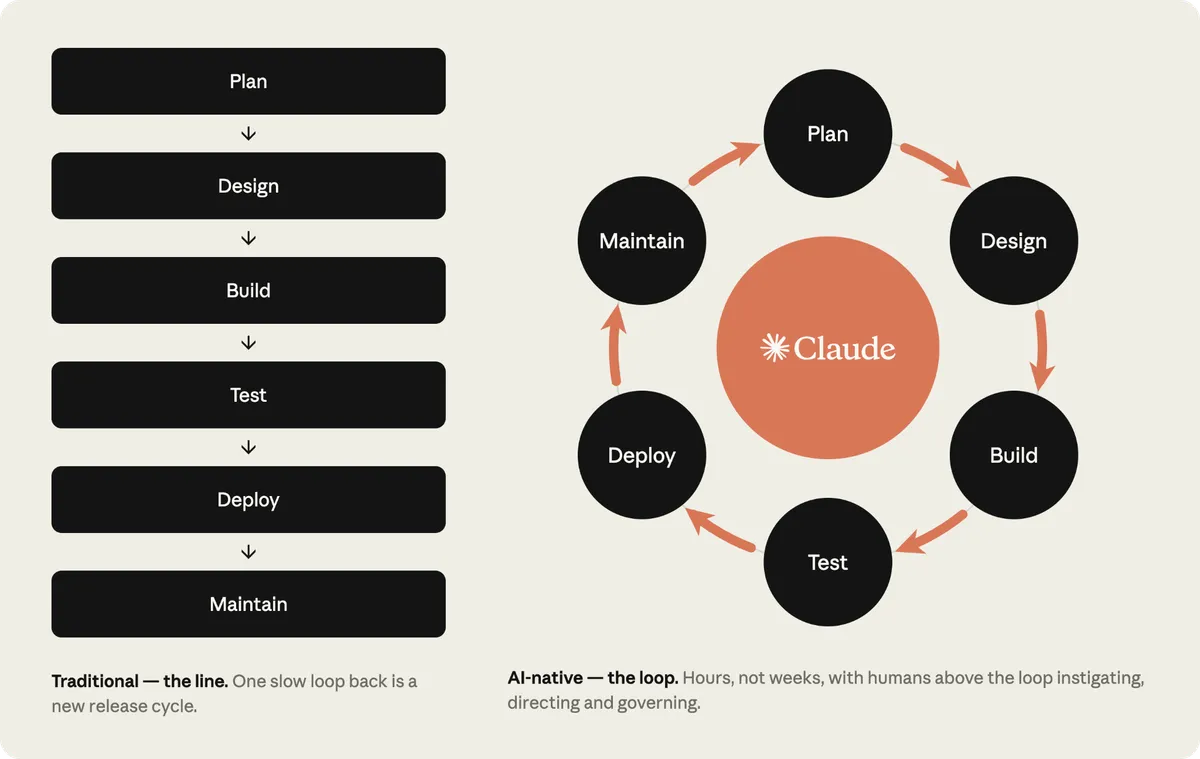
Die Form des Wandels: eine Linie, in der eine einzige langsame Schleife zurück einen neuen Release-Zyklus bedeutet. Dagegen eine Schleife, die in Stunden läuft, mit Menschen darüber, die anstoßen, lenken und beaufsichtigen. Abbildung aus Anthropic - The AI-Native SDLC Playbook (öffnet in einem neuen Tab), August 2026, mit Quellenangabe wiedergegeben.
Nützlicher ist das Playbook bei der Reihenfolge der Einführung. Es zeichnet sie als Abhängigkeitsgraph statt als Sequenz. Denn die Reihenfolge, in der ihr die Plays einführt, ist nicht die Reihenfolge, in der die Stufen laufen. Auf fünf Plays zeigt nichts, ihr könnt sie heute in beliebiger Reihenfolge starten: Absicht erfassen, CLAUDE.md, dem Agenten eine Feedbackschleife geben, Hooks und Plan Mode. Alles andere wartet auf diese fünf. Skills hängen an der CLAUDE.md. Subagents hängen an der CLAUDE.md und der Feedbackschleife. Evals hängen an CLAUDE.md, Feedbackschleife und Hooks. Erst dann werden die Prozess-Plays erreichbar. Anforderungen und Design brauchen erfasste Absicht plus Skills, PR-Review braucht Evals. CI/CD braucht PR-Review plus Plan Mode. Die Schleife autonom zu schließen liegt fünf Ebenen tief und wird erst erreichbar, wenn CI/CD und erfasste Absicht beide stehen (Anthropic - The AI-Native SDLC Playbook (öffnet in einem neuen Tab), August 2026, Anbieter; das zeigt der Graph, nicht der Fließtext). Die Reihenfolge ist mehr wert als die Taxonomie der Stufen darüber. Sie sagt klar: Die autonome Wartungsschleife, die alle vorführen wollen, verdient sich ein Team zuletzt. Sie ist nicht das Erste, was es installiert.
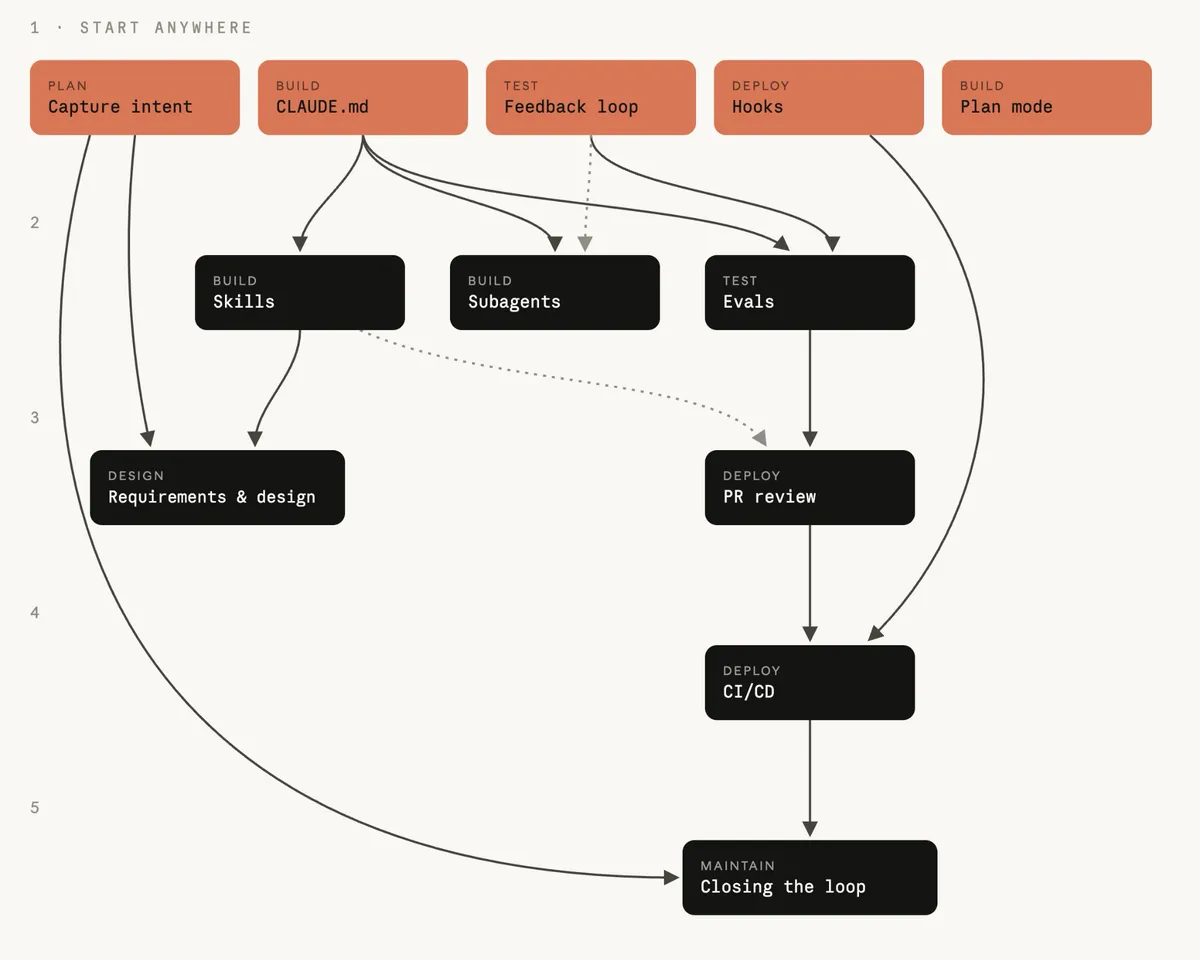
Die Reihenfolge der Einführung als Abhängigkeitsgraph: Die fünf Plays in der oberen Reihe brauchen nichts vor sich, und jeder Pfeil ist eine Voraussetzung. Abbildung aus Anthropic - The AI-Native SDLC Playbook (öffnet in einem neuen Tab), August 2026, mit Quellenangabe wiedergegeben.
Die Ökonomie dreht sich gegenüber klassischem Programmieren um. Planung ist der teure Schritt mit großer Hebelwirkung, Ausführung ist billig. Ein dokumentierter Build brauchte 30 Minuten für die Spec und 10 Minuten für die Ausführung. Heraus kamen 80 % einer funktionierenden 3D-Anwendung. Jede spätere Iteration ging schneller, weil die Spec das Ziel festlegte. Die Spec wurde zum lebenden Dokument, und im Lauf des Projekts entstanden daraus eigene Specs für Iteration und Security (Ona - Spec-driven design: why planning is the new coding (öffnet in einem neuen Tab)). Im Maßstab einer Flotte wird dieselbe Logik zur Warnung. Mehrdeutige Anforderungen kosten dann mehr als Tempo: Sie vervielfachen sich über Dutzende paralleler autonomer Läufe. Eine Spec, die dort besteht, verlangt echtes Verständnis von Architektur, Integrationsgrenzen, Edge Cases und Invarianten. Die Spec ist explizit gemachtes Produktdenken. Deshalb holen starke Engineers mehr Hebel aus diesen Tools, nicht weniger (The Factory Model (öffnet in einem neuen Tab)).
Die Tools sind bei dieser Form angekommen. GitHubs eigenes Spec Kit fährt eine Schleife in vier Phasen: Specify, Plan, Tasks, Implement. Jede Phase wird validiert, bevor die nächste beginnt. GitHub beschreibt den Wandel als Weg vom Code als Source of Truth zur Absicht als Source of Truth. Laut GitHub funktioniert es am besten bei Greenfield-Projekten, bei Feature-Arbeit an bestehenden Systemen und bei der Modernisierung von Legacy (GitHub - Spec-driven development with Spec Kit (öffnet in einem neuen Tab), 2025). Agent OS von Builder Methods ergänzt die Ebene der Standards. Es erkennt Coding-Konventionen in einer bestehenden Codebasis und speist sie in die Ausarbeitung der Spec ein. So passt generierter Code zu den Hausregeln (Builder Methods - Agent OS (öffnet in einem neuen Tab), Anbieter). Der Neubau in v3 reduziert das Framework auf das, was der native Plan Mode nicht leistet. Er indexiert Standards in einem Manifest, damit der Agent bei Bedarf nur die relevanten lädt. Und er interviewt den:die Autor:in, um die Gründe hinter Konventionen festzuhalten, die ein Scan des Codes nicht zeigt (Agent OS v3 (öffnet in einem neuen Tab), 2026).
Die BMAD Method verpackt dieselbe Disziplin als skalierende Workflows mit 12+ Agenten-Personas. Sie passt die Planungstiefe an, vom Bugfix bis zum Enterprise-System (bmad-code-org - BMAD Method (öffnet in einem neuen Tab)). Die radikalste Form verlegt die Spec in die Sprache selbst. Intent ist eine Contract-basierte Sprache: KI soll sie generieren, Menschen sollen sie verifizieren. Vor- und Nachbedingungen sind dort Teil der Struktur, also prüft ihr Deklarationen statt Implementierungen (Intent (öffnet in einem neuen Tab)). Spezifikationen entstehen zunehmend ebenso für Agenten wie für Menschen. Sie werden als maschinell abfragbare Artefakte ausgeliefert (ein MCP-Endpunkt, eine llms.txt, eine text/markdown-Ansicht jeder URL). So kann ein Agent direkt gegen sie prüfen, statt Prosa zu parsen (The Website Specification (öffnet in einem neuen Tab), 2026).
AWS Labs verpackt die Lebenszyklus-Variante derselben Disziplin als Steering Rules für Coding-Agents. Ein harness-neutraler Kern installiert sich in sieben Harnesses, darunter Claude Code, Kiro, Codex CLI, Cursor, opencode und GitHub Copilot. Das README listet fünf Phasen mit 33 Stufen, von Initialization über Ideation, Inception und Construction bis Operation. Dazu kommen 14 Agenten: 11 Fachexperten-Agenten, zwei Reviewer und ein Composer, der den Workflow anpasst. Elf Workflow-Profile decken Arbeit vom Bugfix oder Proof of Concept bis zur Enterprise-Lieferung ab. Die Anfrage wählt den Workflow, und der Agent fragt nach den Entscheidungen, die ihm fehlen. Vor dem nächsten Schritt hält er an menschlichen Freigabepunkten an. Ein Audit-Trail mit 123 Ereignissen, persistenter Zustand und gelernte Regeln halten Anforderungen, Entscheidungen, Code, Tests und Betrieb verbunden. Das beantwortet das Problem, das das Projekt selbst benennt: Ad-hoc-Coding mit KI verliert Kontext, wenn ein Projekt wächst (awslabs - aidlc-workflows (öffnet in einem neuen Tab), MIT-0, Selbstbeschreibung des Anbieters, Stand Version 2.11.1, Oktober 2026).
Am deutlichsten zeigt ein Verification-first-Port die Spec als ausführbares Ziel. Ihr nehmt Spec und Testsuite einer bestehenden Bibliothek als festes Ziel, richtet den Agenten darauf aus und implementiert, bis jeder Test besteht. Reco baute JSONata so in Go nach. Gemeldet werden 13.000 Zeilen und 1.778 bestandene Tests in rund sieben Stunden für 400 Dollar an Tokens. Danach validierte Reco den Port im Shadow Mode gegen die Referenzimplementierung, bevor er in Produktion ging (Selbstauskunft, Reco - We Rewrote JSONata with AI (öffnet in einem neuen Tab), 2026). Die Testsuite ist die Spezifikation. Ob jeder Test gegen die Referenz grün ist, ist eine Prüfung, mit der der Agent nicht diskutieren kann. Deshalb erwartet der Autor, dass chirurgische KI-Refactorings zur Routine werden.
Dieselbe Verification-first-Logik portiert ganze Codebasen in andere Sprachen. Subagents pro Datei überführen die bestehenden Tests und den Quellcode in Spezifikationen, die per Zitat auf ihre Fundstellen verweisen. Dann implementiert eine autonome Schleife gegen diese Specs, bis ein streng kompiliertes Ziel durchläuft. Über die Zitate holt sie bei Bedarf die ursprüngliche Implementierung hervor (Porting software has been trivial for a while (öffnet in einem neuen Tab), 2026).
Zwei Artefakte tragen das Verhalten, das ein Schema nicht fassen kann. Architecture Decision Records müssen maschinell durchsetzbar sein, Prosa allein reicht nicht. Haltet das Warum fest und sichert es mit einer Lint- oder Import-Regel ab. Ein Verstoß führt den Agenten dann direkt zurück zum Dokument, damit er ihn behebt. Ausführbare Spezifikationen, BDD-Szenarien im Given/When/Then-Stil von Cucumber, schließen die Lücke, die Spec-driven Development sonst offenlässt. Wie prüft ihr, ob das Produkt wirklich der Spec entspricht? Eines ist noch schwerer, als KI-Code zu lesen: KI-Tests zu lesen (Capturing Decisions for Humans and AI Alike (öffnet in einem neuen Tab), 2026). Stärker ist es, ganze Fehlerklassen strukturell zu verhindern, statt einzelne Fälle abzufangen. Verbietet der BDD-Suite, ein Modul mit Datenbankzugriff zu importieren, dann kann diese Klasse von Fehlern nicht wiederkehren. Und lasst den Harness selbst die Verstärkungsschleife sein. Git-Hooks plus CI mit denselben Prüfungen hindern einen Agenten daran, sie zu überspringen (Capturing Decisions for Humans and AI Alike (öffnet in einem neuen Tab), 2026).
Nicht alle halten mehr Spezifikation vorab für die Antwort. Die ganze Lösung zu spezifizieren, bevor der Agent eine Zeile schreibt, ist Wasserfall im neuen Gewand. Denselben Fehler wiederholt das Versprechen der Dark Factory. Der bessere Schritt ist, das Problem zu spezifizieren, nicht die Lösung. Benennt Constraints, Nutzer:innen, die Form des bestehenden Systems und Erfolgskriterien. Die Implementierung bleibt offen, damit der Agent daran iteriert und sie verteidigt (How I Use AI to Code (öffnet in einem neuen Tab), 2026). Das Label selbst ist durch Übernutzung verschwommen (Semantic Diffusion im etablierten Sinn). Unter dem Branding ist ein Agent immer noch nur Tools in einer Schleife. Ob ein Team “do spec-driven development” für sich beansprucht, ist deshalb die falsche Frage. Nützlich ist die Frage, ob eure Specs und Tests den Agenten wirklich einschränken (Advanced Context Engineering for Coding Agents (öffnet in einem neuen Tab), 2026).
Ein Praktiker, der Plan-first-Läufe ausprobiert hat, berichtet jedes Mal vom selben Scheitern. Die Agenten stoßen auf Fälle, die der Plan übersehen hat. Der Mensch stoppt sie, schreibt den Plan neu und fängt von vorn an. Sein Argument dagegen sind die Kosten einer Änderung. Kostet jede Änderung etwa so viel wie der erste Build, ist ein Plan vorab die teure Option. Story für Story zu iterieren, mit einem Architektur-Review nach jeweils ein oder zwei Stories, ist die billige. Dieser Praktiker hält Spezifikationen flüchtig, statt sie im Repository zu speichern. Bei Tools, die er veröffentlicht, rät er anderen, ihre Agenten auf seine Version zu richten und eine eigene zu bauen. So dient das fertige Artefakt als Spezifikation (LIVE: Uncle Bob on Software Fundamentals in the Age of AI (öffnet in einem neuen Tab), August 2026, Praktiker).
Derselbe Wasserfall-Vorwurf kommt mit Zahlen zurück. Scott Logic baute ein Feature von rund 1.000 Zeilen in einer Hobby-Web-App mit GitHubs Spec Kit nach. Dabei lief GitHub Copilot auf Claude Sonnet 4.5. Scott Logic wählte ein schon gebautes Feature, damit die Spezifikation eindeutig sein konnte. Die vier Schritte vor der Implementierung, von der Constitution bis zu den Tasks, erzeugten 2.577 Zeilen Markdown für 689 Zeilen Code. Der ganze Lauf kostete 33,5 Minuten Agentenzeit und rund 3,5 Stunden Review. Allein der Plan-Schritt schrieb 2.067 dieser Zeilen. Darunter war ein Recherchedokument mit 406 Zeilen, das die UI-Bibliothek begründete, die jede andere Seite der App schon nutzte. Der generierte Code scheiterte trotzdem beim ersten Start an einem offensichtlichen Bug. Eine Formularvariable wurde nie aus dem Datastore geladen, und keine Änderung an der Spezifikation konnte das ausdrücken. Ein zweites, kleineres Inkrement kostete weitere 2.262 Zeilen Markdown und rund zwei Stunden Review. Auf dem üblichen Weg entstand die Funktionalität in kleinen, per Prompt gesteuerten Inkrementen mit funktionalen Tests dazwischen. Das dauerte 8 Minuten Agentenzeit, 15 Minuten Code-Review und 9 Minuten Tests und Fixes, ohne Bugs. Das Review schätzt diesen Weg als rund zehnmal schneller ein als den Lauf mit Spec Kit (Scott Logic - Putting Spec Kit Through Its Paces: Radical Idea or Reinvented Waterfall? (öffnet in einem neuen Tab), November 2025).
Der strukturelle Einwand des Reviews lautet: Markdown ist ein schwaches Gesetz. Code ist eine formale Sprache, die sich testen und als richtig oder falsch beweisen lässt. Eine Markdown-Spezifikation ist das nicht. Wer die Spec zur Source of Truth macht, vertraut also dem weniger formalen Artefakt. Vieles, was Spec Kit erzeugte, war Duplikat oder erfundener Kontext. Ein Beispiel ist eine Design-Begründung über Nutzer:innen, die an der Rennstrecke Handschuhe tragen, obwohl das niemand gesagt hatte. Eine Spezifikation ist zudem meist ein Werkzeug für einen Zeitpunkt, das nach dem Release des Features niemand mehr ansieht. Die Architektur- und Designentscheidungen hinter dem Code bleiben dagegen festhaltenswert, denn dieses Warum kann der Code nicht tragen. Agenten machen Code billig zu erzeugen und wegzuwerfen. Eine sequenzielle Spezifikations-Pipeline verschenkt deshalb die schnellere Iteration, die sie möglich machen. Das Review nennt seine eigenen Vorbehalte. Spec Kit war unausgereift, mit offenen Fragen dazu, wie sich Specs weiterentwickeln und Bugfixes einfließen. Und ein Engineer, der jedes Inkrement prüft und steuert, gehört vielleicht nicht zur Zielgruppe (Scott Logic - Putting Spec Kit Through Its Paces: Radical Idea or Reinvented Waterfall? (öffnet in einem neuen Tab), November 2025).
Die Continuous-Delivery-Community gibt ihrer Version einer leichtgewichtigen Praxis, die unterwegs neu plant, eine Uhr. Eine Änderung zu spezifizieren sollte unter 15 Minuten dauern. Dauert eine Spec länger, gehört die Änderung geteilt. Jede Spec deckt einen dünnen vertikalen Schnitt ab, etwa ein einzelnes Szenario. Bevor Code entsteht, prüft der Agent Absicht, Szenarien, Constraints und Akzeptanzkriterien als Ganzes. Er sucht vage Formulierungen, fehlende Fälle, widersprüchliche Begriffe und eine Hypothese, die niemand messen kann. An diesem Punkt kostet eine Änderung zum letzten Mal fast nichts. Eine nützliche Kritik fragt den Agenten nach Szenarien, die zwei verschiedene Implementierungen beide bestehen würden. Ein solches Szenario legt nämlich nichts fest. Für größere Arbeit beschreibt der Leitfaden eine Discovery-Schleife in vier Phasen. Der Mensch rahmt die Absicht mit einer groben, messbaren Hypothese. Der Agent interviewt in Runden von drei bis fünf gezielten Fragen. Der Mensch antwortet mit rohem Kontext, den der Agent später strukturiert. Der Agent entwirft die Spezifikation und kritisiert danach seinen eigenen Entwurf auf vage Constraints und fehlende Edge Cases. Der Unterschied zum Prompting Zug um Zug liegt darin, wo die Iteration stattfindet. Die Spec steht fest, bevor ein Implementierungs-Agent startet, statt dass der Code hinterher korrigiert wird (MinimumCD.org and DojoConsortium.org - Agent-Assisted Specification (öffnet in einem neuen Tab), Stand September 2026).
Eine Grenze überlebt auch diese leichtgewichtige Praxis: Specs sind unverzichtbar, aber kein Beweis für Korrektheit. In der Praxis sind sie unvollständig, beruhen auf Hypothesen und liegen manchmal falsch. Je selbstsicherer sie geschrieben sind, desto gefährlicher wird eine Implementierung, die niemand hinterfragt. Die Source of Truth einer reifen agentischen Pipeline sind programmatische Tests und Fitness Functions. Die Spec beschreibt die Absicht, Tests prüfen die Realität. Wo beide auseinanderlaufen, gewinnt die Realität (Dark Factory Patterns).
Quellen
Lifecycle-Playbooks
- AI-DLC Workflows (öffnet in einem neuen Tab) - Steering Rules unter MIT-0 für Coding-Agents: 33 Lebenszyklus-Stufen, 14 Agenten und menschliche Freigabepunkte in einem Kern für sieben Harnesses.
- The AI-Native SDLC Playbook (öffnet in einem neuen Tab) - Leitfaden von Anthropic, Stufe für Stufe, wie sich die sechs SDLC-Stufen um committete Artefakte, agentisches Review und Monitoring mit Kontrollbändern neu aufbauen lassen.
Spezifikationspraxis
- Agent-Assisted Specification (öffnet in einem neuen Tab) - Seite eines Community-Leitfadens zum Entwerfen von Specs pro Änderung mit einem Agenten als Kritiker, begrenzt auf 15 Minuten pro Änderung, CC BY 4.0.
- Putting Spec Kit Through Its Paces: Radical Idea or Reinvented Waterfall? (öffnet in einem neuen Tab) - Praxistest von Scott Logic, der ein Feature einer Web-App mit Spec Kit nachbaut und Markdown-Umfang, Agentenzeit und Review-Stunden mit iterativem Prompting vergleicht.