AEMM: Evidenz aus der Industrie
Die Evidenz aus der Industrie zeigt: Die meisten Unternehmen stagnieren bei moderaten Produktivitätsgewinnen durch KI. Größere Gewinne folgen aus Codequalität, umgebauten Teams und gemessenen Ergebnissen, nicht aus der Tool-Wahl. Externe Reifegradmodelle lassen sich den AEMM-Leveln zuordnen und prüfen ein Assessment gegen, ersetzen es aber nicht.
Verfasst von
-

Benedikt Stemmildt Gründer & Co-CEO
Aktualisiert:
Agentic Engineering 5
Unsere Position. Für uns gilt: Nutzung ist kein ROI (öffnet in einem neuen Tab). Ein Team kann das Tool intensiv nutzen und trotzdem nicht schneller liefern, denn das Tippen war nie der Bottleneck. Statt das Playbook eines anderen Unternehmens zu kopieren, messen wir unsere eigene Baseline (öffnet in einem neuen Tab). KI-Ergebnisse schwanken zwischen Organisationen zu stark, um sich übertragen zu lassen.
Eine Forschungsgruppe in Stanford mit mehr als 100.000 Engineers aus mehr als 600 Unternehmen in ihrem Datensatz sieht den durchschnittlichen Netto-Produktivitätsgewinn durch KI bei etwa 15 bis 20 %, nachdem die Nacharbeit an den von der KI eingebauten Bugs abgezogen ist (Does AI Actually Boost Developer Productivity? (öffnet in einem neuen Tab)). In einem späteren Talk stellte dieselbe Gruppe 46 Teams mit KI 46 vergleichbaren Teams ohne KI gegenüber. Der Median des Nettogewinns lag bei etwa 10 %, und der Abstand zwischen den besten und den schwächsten Teams wächst (Can You Prove AI ROI? (öffnet in einem neuen Tab)).
Was sagt die Evidenz aus der Industrie zu den einzelnen AEMM-Leveln?
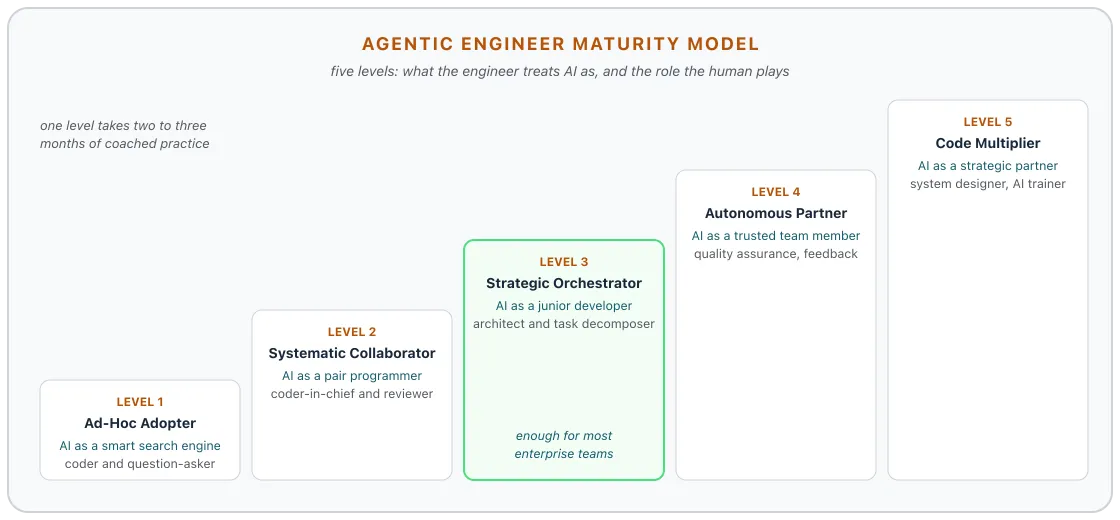
Abbildung 1. Mit jedem AEMM-Level wandert die Rolle des Menschen vom Coder zum Systemdesigner. Die meisten Enterprise-Teams liefern ihren Wert auf Level 3. Deshalb lesen wir die externen Modelle unten an diesen fünf Stufen, nicht als Wettlauf zu Level 5. Diagramm von hackers&wizards.
Externe Reifegradmodelle und ihre AEMM-Level
- Ein Praxismodell mit fünf Leveln passt eng dazu: L1 (10 % Automatisierung, Copilot), L2 (60-70 %, Multi-Threading-Agenten), L3 (80-90 %, Teams aus 2-3 Personen), L4 (95-98 %, Plattform-Teams + 47 Agenten), L5 (99 %, nur noch strategische Aufsicht) (ProgrammierEnde (öffnet in einem neuen Tab), Mayflower).
- OpenAI teilt in drei Stufen: Delegate (Routinearbeit, die Agenten erledigen), Review (braucht menschliche Bewertung), Own (Entscheidungen, die Urteilsvermögen verlangen). Agenten setzen im ersten Durchgang um, Engineers werden zu Reviewer:innen (Building an AI-Native Engineering Team (öffnet in einem neuen Tab), OpenAI Codex).
- Das Framework von GitHub stützt die KI-Einführung auf 8 Säulen: AI Advocates, Clear Policies & Guardrails, Learning & Development, Data-Driven Metrics, Dedicated Leadership (DRI), Executive Support, Right-Fit Tooling und Communities of Practice (AI-Powered Workforce Playbook (öffnet in einem neuen Tab), GitHub).
- Agenten werden nach ihrer Raffinesse gestuft: statisch, reaktiv, deliberativ, lernend, sich selbst weiterentwickelnd autonom. MCP ersetzt dabei klassische APIs als Integrationsstandard (Die neue Architektur (öffnet in einem neuen Tab)).
- Eine Analogie zur Kapazitätsverdopplung von KI-Agenten schätzt eine Verdopplung alle 7 Monate bei allgemeinen Aufgaben und alle 70 Tage bei Code-Aufgaben. Das ergibt 4-6 Verdopplungen pro Jahr bei der Kapazität für Code-Aufgaben (Devin 2.0 and the Future of SWE (öffnet in einem neuen Tab), Cognition).
- Der “agentic layer” ist der Meta-Code um eine Codebase, der Agenten beibringt, sie zu bedienen. Dieses Modell bewertet ihn in Stufen von 1 bis 5: Stufe 1 (CLAUDE.md plus ein Prime-Befehl), Stufe 2 (spezialisierte Prompts, Spec-Verzeichnisse, Subagents), Stufe 3 (Koordinationsdateien agents.md), Stufe 4 (Closed-Loop-Prompts mit Zyklen aus Request, Validate und Resolve), Stufe 5 (mehrere spezialisierte Prompts, MCP-Server, Skills). Die These dahinter heißt “codebase singularity”: Ist diese Schicht stark genug, bedienen Agenten die Codebase wirksamer als jeder einzelne Engineer. Das Modell bewertet den Harness, nicht den Engineer. Deshalb ergänzt es das AEMM, statt es zu wiederholen (The Codebase Singularity (öffnet in einem neuen Tab)).
Konkrete Kennzahlen pro Level
- Bei einfacher KI-Einführung (AEMM L2) bleibt die Ersparnis klein, selbst mit optimistischen Annahmen: 40 % der Cycle Time sind Coding, 60 % davon lassen sich mit KI unterstützen, und das geht 55 % schneller. Insgesamt spart das nur ~13 % des gesamten Delivery-Zyklus (XP Keynote - AI for teams (öffnet in einem neuen Tab)).
- Auf dem Level der Inner-Loop-Agenten (AEMM L3-L4) steigt die Produktivität bei der Implementierung um 40-50 %. Die Zeit fürs Debugging kann allerdings wachsen (Agents in the Outer Loop (öffnet in einem neuen Tab), OpenHands).
- Bei vollständiger Modernisierung (AEMM L4-L5): 10-20x Tempo, 90-95 % Automatisierung, 3 Monate statt 18 Monate auf klassischem Weg, ~200k EUR + 30k EUR für KI statt 900k EUR klassisch (Modernisierung mit AI (öffnet in einem neuen Tab)).
- Ein Engineering-Team berichtet, fünf Jahre Legacy-Software in elf Monaten neu gebaut zu haben, mit einem Drittel der ursprünglichen Besetzung. Voraus ging ein zweiwöchiger KI-Analysedurchgang über fünfzehn Legacy-Projekte. Die technische Leitung schreibt nach eigener Aussage seit Januar keinen Code mehr von Hand. Der Titel der Episode spricht von 72-mal schnellerer Lieferung als auf dem klassischen Weg. Einschränkung: Das ist die Selbstauskunft eines einzelnen Unternehmens über einen Neubau mit bekanntem Ziel. Veröffentlicht hat sie eine Beratung, die genau diesen Umstieg verkauft, und ein unabhängiges Audit gibt es nicht (Integrating AI into development processes (öffnet in einem neuen Tab), 18. Mai 2026).
- Die Kohorte mit hoher Adoption (über dem 75. Perzentil) steigert das Codevolumen um 61,3 %. Bei der Kohorte mit geringer Adoption (unter dem 25. Perzentil) sinkt es um 11,4 %. Die Differenz von 72,7 Prozentpunkten zeigt, dass die Intensität der Nutzung zählt (Measuring AI’s True Impact (öffnet in einem neuen Tab)).
- Booking.com: Tägliche KI-Nutzer:innen erreichten 16 % mehr Code-Durchsatz. Die Zufriedenheit der Entwickler:innen stieg in sechs Monaten um 15 Punkte. Vollständig umgestellte Teams zeigten 30 % mehr Durchsatz (Booking.com Measures AI Impact (öffnet in einem neuen Tab), Tiatra).
- Dropbox kommt auf 90 % KI-Adoption. Der eigentliche Wert zeigte sich erst in der Korrelation mit 20 % mehr gemergten Pull Requests bei sinkenden Change Failure Rates (How Tech Companies Measure AI Impact (öffnet in einem neuen Tab), The Pragmatic Engineer).
Teamgrößen über die Level hinweg
- Die Teams schrumpfen, während sich der Output vervielfacht: 7 Personen (L2), 3 Personen (L3), Ops-Teams (L4+). Quelle ist das Praxismodell mit fünf Leveln.
- Laut demselben Praxismodell wandeln sich die menschlichen Rollen über die Level: Coder (L1-L2), KI-Orchestrator:innen (L3), Strateg:innen (L4-L5).
- Klassische agile Praktiken werden auf höheren Reifegraden obsolet. Auf Level 4 wächst die Infrastruktur drastisch, mit 100x KI-Workloads. Auch das stammt aus dem Praxismodell mit fünf Leveln.
- Every schreibt: “A single developer can do the work of five developers a few years ago when properly leveraging AI systems” (Compound Engineering (öffnet in einem neuen Tab), Every).
- Every betreibt fünf Produkte. Jedes davon baut und betreibt im Wesentlichen eine Person, und jedes nutzen Tausende Menschen jeden Tag (Compound Engineering).
Messansätze aus der Industrie
- Die 18 untersuchten Unternehmen setzen KI-spezifische Kennzahlen auf bewährte Messungen der Developer Productivity (Change Failure Rate, PR-Durchsatz). Sie fangen nicht bei null an (die Umfrage von The Pragmatic Engineer).
- Ein Framework misst in drei Dimensionen: Nutzung (Adoptionsraten), Wirkung (Produktivitätsgewinne und Qualitätskennzahlen) und Kosten (ROI und Governance) (Measuring AI Code Assistants and Agents (öffnet in einem neuen Tab), DX).
- Das DX Q1 2026 AI Measurement Framework ergänzt ein konkretes Kennzahlenset namens “Core 4”. Dazu gehören PR-Durchsatz, wahrgenommene Liefergeschwindigkeit, Developer Experience Index (DXI), Wartbarkeit des Codes, Vertrauen in Änderungen und Change Fail %. Für autonome Agenten kommen Human-Equivalent Hours (HEH) hinzu. Unabhängig und über 400+ Unternehmen hinweg landet es bei denselben vier KPIs wie Wirkung von Agentic Engineering messen. Mehr dazu im DX AI Impact Report (DX).
- Industrie-Benchmark (Q1 2026, 400+ Unternehmen): 93 % KI-Adoption, im Schnitt 3,9 Std./Woche Zeitersparnis (4,72 bei täglichen Nutzer:innen), 27,4 % von KI geschriebener Code. Der Median des PR-Durchsatzes liegt bei 2,4/Woche für tägliche Nutzer:innen und bei 1,5 für Nichtnutzer:innen. Die Change Failure Rate verschob sich bei manchen Firmen um ~2 Prozentpunkte, das sind ~50 % mehr Defekte. Das Ergebnis hängt an Befähigung und Messung, nicht an der Tool-Wahl (DX Q1 2026 Impact Report).
- Die Messung durchläuft drei Phasen. Phase 1 misst die Breite (MAU/MEU), Phase 2 die Tiefe (Segmentierung der Nutzer:innen), Phase 3 die Wirkung aufs Geschäft (Cycle Time, Qualität, Wohlbefinden) (GitHub AI-Powered Workforce Playbook).
- Microsoft misst “bad developer days”, Glassdoor verfolgt, wie oft experimentiert wird. Monzo meidet KI bewusst in Bereichen mit Kundendaten, trotz möglicher Effizienzgewinne (How Tech Companies Measure AI Impact (öffnet in einem neuen Tab)).
- Unternehmen vergleichen KI-Nutzer:innen mit Nichtnutzer:innen, den Stand vor der Einführung mit dem danach und arbeiten mit Kohortenanalysen. Webflow fand heraus, dass Engineers mit 3+ Jahren im Unternehmen am meisten Zeit sparten (How Tech Companies Measure AI Impact (öffnet in einem neuen Tab)).
- Fünf automatisierte Qualitätsindikatoren lassen sich aus Git ablesen: große Commits (Ziel <20 %), ausufernde Commits (Ziel <10 %), Test-first-Disziplin (Ziel >50 %), Dateien pro Commit (Ziel <5) und Zeilen pro Commit (Ziel <100) (PDCA Framework for AI Code Generation (öffnet in einem neuen Tab), InfoQ).
- Laut Google DORA 2024 geht jede Steigerung der KI-Adoption um 25 % mit 7,2 % weniger Stabilität in der Delivery einher. GitClear meldet zehnmal so viele duplizierte Codeblöcke. Eine separate Klon-Studie, die derselbe Artikel zitiert, beziffert die Fehlerquote von geklontem Code auf 17 % (PDCA Framework for AI Code Generation).
Stanford-Studie mit 120.000 Entwickler:innen (ROI-Evidenz)
- Ein späterer Talk der Forschungsgruppe hinter der Studie mit 100.000 Entwickler:innen weiter unten: 46 Teams mit KI, gegenübergestellt mit 46 vergleichbaren Teams ohne KI, der Netto-Produktivitätsgewinn quartalsweise gemessen. Der Median lag im Juli 2025 bei etwa 10 %. Der Abstand zwischen den Top-Teams und dem Rest wächst, ein Effekt “Rich get richer”: Frühe Anwender:innen könnten ihre Gewinne weiter steigern, während die Nachzügler weiter zurückfallen (Can You Prove AI ROI? (öffnet in einem neuen Tab), Stanford).
- Ein experimenteller Index für die Sauberkeit der Umgebung korreliert mit den Produktivitätsgewinnen durch KI (R-sq 0,40), laut Vortrag “a pretty decent correlation”. Der Index setzt sich aus Tests, Typen, Dokumentation, Modularität und Codequalität zusammen, und der Vortrag rät, in die Hygiene der Codebase zu investieren. Die Ausgaben für KI-Tokens korrelieren nur lose (R-sq etwa 0,20). Die Qualität der Nutzung zählt mehr als die Menge (die Stanford-Studie).
- Aktivitätskennzahlen (Codezeilen, PR-Zahlen, DORA), die “mehr” zeigen, ohne “besser” zu belegen, weisen keinen Wert nach. Die Studie empfiehlt Engineering-Output als Hauptkennzahl und als Guardrails Kennzahlen zu Nacharbeit und Refactoring, zu Qualität und Risiko sowie zu Menschen und DevOps (die Stanford-Studie). Selbsteinschätzung ist unzuverlässig: In einem früheren Experiment derselben Gruppe mit 43 Entwickler:innen verschätzten sich die Befragten um etwa 30 Perzentilpunkte (Stanford 100k Developers Study (öffnet in einem neuen Tab)).
- Die Studie stuft von keiner KI-Nutzung (Level 0) bis zur agentischen Orchestrierung (Level 4). Die wachsende Lücke zwischen Top-Teams und Schlusslichtern schreibt der Vortrag nach eigener Aussage “very unscientifically and very illustratively” fort, ohne eine Zahl zu nennen (die Stanford-Studie).
McKinsey-Daten zur Transformation von Unternehmen
- Die meisten Unternehmen stagnieren bei 5-15 % Produktivitätsgewinn durch KI. Top-Performer erzielen mit KI-nativen Workflows 7x bessere Ergebnisse und bauen Rollen 6x häufiger um. 70 % der befragten Unternehmen haben ihre Rollendefinitionen nicht geändert (Moving away from Agile (öffnet in einem neuen Tab), McKinsey).
- Pods aus 3-5 Personen ersetzen Teams aus 8-12 Personen. Spec-Driven Development ersetzt Story-Driven Development: PMs iterieren Specs mit Agenten, bevor Entwickler:innen Code schreiben. Kontinuierliche Planung ersetzt Quartals-Sprints (McKinsey).
- In der Fallstudie einer Bank stiegen die Code-Merges nach dem Umbau um 51 %, der Agenten-Verbrauch um das 60-Fache. Der Wandel ist strukturell und vergleichbar mit dem Schritt von Wasserfall zu Agile (3-6 Monate Redesign) (McKinsey).
- Den schwächsten Unternehmen fehlen grundlegende Output-Kennzahlen: “only 10% were measuring productivity” (McKinsey).
Muster für Agenten-Autonomie
- Drei Säulen der Autonomie: Frontier-Modelle, fortgeschrittenes Kontextmanagement und erschöpfende Verifikation. Investieren müsst ihr in alle drei. Replit Agent entwickelte sich vom einzelnen Agenten im ReAct-Stil zum Multi-Agent-System (Manager, Editor, Verifier). Der “Ralph mode” erreicht 90 % Autonomie (Autonomy Is All You Need (öffnet in einem neuen Tab), Replit).
- Führung im Moment der Entscheidung: Situative Instruktionen kommen an Schlüsselstellen dazu, statt alle Regeln vorab zu laden. “We don’t strive for full autonomy. We want the user to stay involved and engaged” (der Replit-Talk).
- Die zentrale Herausforderung sind sich aufschaukelnde Fehler: “The longer the trajectory, the more likely the agent makes an error.” In der Multi-Agent-Architektur übernimmt deshalb jeder Agent die kleinstmögliche Aufgabe, damit Fehler unwahrscheinlicher werden (der Replit-Talk).
- Compounding Engineering folgt vier Schritten: Plan, Delegate, Assess, Codify. 15 Personen betreuen 4 Produkte. “A single developer can do the work of five developers a few years ago” (Dispatch from the AI-native Future (öffnet in einem neuen Tab), Every).
Evidenz aus der Praxis
12-Factor Agents: Zuordnung zu den AEMM-Leveln
- Agenten sind Software, keine Magie. Die meisten Agenten in Produktion sind “not that agentic at all”. Es ist überwiegend deterministische Software mit kleinen LLM-Schleifen aus 3-10 Schritten (“micro agents”). Was funktioniert, ist ein überwiegend deterministischer DAG mit sehr kleinen Agenten-Schleifen an den Entscheidungspunkten. Das entspricht AEMM L2-L3: Teams bauen verlässliche Agenten, bevor sie volle Autonomie anstreben (12-Factor Agents (öffnet in einem neuen Tab), AI Engineer, 3. Juli 2025).
- Prompts, Kontextfenster und Control Flow gehören euch. Das sind die drei Säulen verlässlicher Agenten: (a) Schreibt jedes Token eurer Prompts von Hand, sobald Qualität zählt. (b) Steuert, was ins Kontextfenster kommt, und hängt Fehler oder Stack Traces nicht blind an. (c) Besitzt die Schleife, die entscheidet, wann, wie und warum der Agent aussteigt. So sehen die Kriterien für den Übergang von L2 zu L3 in der Praxis aus (12-Factor Agents).
- “LLMs are pure functions, tokens in, tokens out, and everything in making agents good is context engineering.” Context Engineering ist der einzige Hebel, den Teams in der Hand haben, solange sie nicht neu trainieren. Das bestätigt Context Engineering als die zentrale Fähigkeit, die AEMM-Level voneinander unterscheidet (12-Factor Agents).
- “Not every problem needs an agent.” Zur Kernkompetenz gehört die Disziplin, zu erkennen, wann ein Bash-Skript in 90 Sekunden reicht. Die Alternative wären 2 Stunden Prompt Engineering für einen Agenten. Wer weiß, wann kein Agent nötig ist, steht auf den höheren Reifegraden, ab L3 (12-Factor Agents).
Custom Agents mit dem Claude Code SDK: Muster für Level 4-5
- Entwicklungspfad: von Better Agents (L2) über More Agents (L3) zu Custom Agents (L4-5). “Out-of-the-box agents are built for everyone’s codebase, not yours.” Custom Agents optimieren für eure Domäne, eure Probleme und eure Grenzfälle (Agentic Coding ENDGAME: Claude Code SDK Custom Agents (öffnet in einem neuen Tab)).
- Der System-Prompt ist “the most important element of your custom agents with zero exceptions.” Wer den System-Prompt von Claude Code komplett überschreibt, ersetzt das Produkt. Danach läuft kein Claude Code mehr, sondern ein Custom Agent. Das ist Verhalten auf L4: domänenspezifische Agenten bauen, statt generische zu konfigurieren.
- Core Four, auf jedem Level im Blick: Context, Model, Prompt (System und User) und Tools.
/toolszeigt alle verfügbaren Tools (15+ eingebaute) plus MCP-Tools. Sie alle belegen Platz im Kontextfenster, auch wenn sie ungenutzt bleiben. Custom Agents auf L4-5 entfernen überflüssige Tools, um Rauschen zu senken und den Fokus zu schärfen. - Micro-SDLC Agent: Ein Multi-Agent-Workflow mit den Stufen Planner, Builder und Reviewer, orchestriert über eine Web-UI mit Echtzeit-Updates per WebSocket. Jeder Agent übergibt an die nächste Stufe. Das Muster des Task Boards (plan, build, review, ship) ist eine konkrete Umsetzung von L4. “Agent coding is not so much about what we can do anymore. It’s about what we can teach our agents to do”
Agent Experts: Systeme, die sich selbst verbessern (Level 4-5)
- Agenten, die sich mit Expertise-Dateien selbst verbessern: Ein “agent expert” ist ein selbstverbessernder Template-Metaprompt mit einer YAML-Expertise-Datei. Diese Datei dient dem Agenten als mentales Modell. Memory-Dateien sind statisch und werden von Hand gepflegt. Expertise-Dateien aktualisiert der Agent dagegen nach jeder Aufgabe selbst, in einem Self-Improve-Schritt (Agent Experts (öffnet in einem neuen Tab), Lektion von Agentic Horizon).
- “The difference between a generic agent and an agent expert is simple. One executes and forgets, the other executes and learns.” Hier liegt der Unterschied zwischen L4 und L5. Agenten auf L4 arbeiten autonom, Agenten auf L5 bauen ihre eigenen Fähigkeiten mit der Zeit kumulativ aus.
- Workflow Plan-Build-Self-Improve: Ein Zyklus aus drei Schritten. Schritt 3 (Self-Improve) schreibt automatisch in die Expertise-Datei, was sich geändert hat. Der Agent verfolgt die Änderungen, prüft sein mentales Modell gegen die Codebase und sammelt Expertise ohne menschliches Zutun. Das ist Verhalten auf L5: Der Agent wird ohne menschliches Coaching besser in seiner Arbeit.
- Meta-Agentics: Prompts schreiben Prompts, Agenten bauen Agenten, Skills bauen Skills. “There is no codebase I create that does not have meta-agentics.” Das ist das Arbeitsprinzip des L5 Code Multiplier: Das System erzeugt seine eigenen Komponenten.
- Agenten nach Problemen skalieren, nicht nach Rollen: Statt eines Agenten für eine Frage setzt ihr drei oder fünf mit demselben Prompt ein. “Sometimes if you throw five agents at the problem, only one makes it.” Kombiniert ihr die Ergebnisse, steigt die Sicherheit.
Kontinuierliches Lernen am System-Prompt (Wegbereiter für Level 3)
- 5-15 % Verbesserung aus 150 Beispielen: Auf SWEBench löste Claude Code 5 % mehr GitHub-Issues, Cline 15 % mehr. Es gab kein Fine-Tuning und keine Änderung am Modell. Verbessert wurde allein der System-Prompt, über LLM-as-Judge-Evals mit Begründungen (System Prompt Learning with Evals (öffnet in einem neuen Tab)).
- Prompt Learning statt RL: Statt skalarer Belohnungen liefert Prompt Learning Feedback auf Englisch. Es erklärt, warum etwas scheiterte und welche Konzepte fehlten. Das kann jedes Engineering-Team, ein Data-Science-Team braucht es dafür nicht. Der Übergang zu L3 heißt: Teams verbessern Agenten-Konfigurationen in strukturierten Eval-Schleifen statt durch Herumprobieren.
- “Writing really good evals is how you get the best insight into what you could do to improve your agents.” Entscheidend ist die Qualität der Evals. Die Verbesserung treibt die Begründung aus dem Eval, nicht der Score.
Konkrete Kennzahlen: AEMM-Level-Indikatoren aus der Praxis
- Stanford, R-squared 0,40 für die Umgebung: Ein Index für die Sauberkeit der Umgebung aus Tests, Typen, Dokumentation, Modularität und Codequalität zeigt “a pretty decent correlation” mit den Produktivitätsgewinnen durch KI, deshalb rät der Vortrag, in die Hygiene der Codebase zu investieren. Die Ausgaben für KI-Tokens zeigen nur ein loses R-squared von etwa 0,20, die Qualität der Nutzung zählt also mehr als die Menge. Diese Kennzahl beziffert den Übergang von L2 zu L3 (Stanford 120k Developers ROI Study (öffnet in einem neuen Tab)).
- Atlassian: 45 % kürzere PR-Cycle-Time mit KI-gestütztem Review im ersten Durchgang. Die Zufriedenheit der Entwickler:innen stieg von 49 % auf 78 %, nachdem Atlassian begonnen hatte, Developer Joy zu messen. Das sind konkrete Kennzahlen für L3 (State of Developer Experience 2025 (öffnet in einem neuen Tab), Atlassian).
- Booking.com: Tägliche KI-Nutzer:innen erreichten 16 % mehr Code-Durchsatz. Die Zufriedenheit der Entwickler:innen stieg in sechs Monaten um 15 Punkte. Vollständig umgestellte Teams zeigten 30 % mehr Durchsatz. Das sind Daten zum Übergang von L2 zu L3.
- METR, 19 % langsamer: Den überraschenden Befund erklärt der Aufwand, zwischen menschlichem Review und Agenten-Ausführung hin und her zu wechseln. Für komplexe Aufgaben ist die Schleife zu eng, für einfache zu locker. Das stützt das Konzept des “Elastic Loop”: Wie eng die Schleife ist, sollte sich dynamisch einstellen lassen (The Elastic Loop (öffnet in einem neuen Tab)).
- Stanford, 100.000 Entwickler:innen: mehr als 100.000 Engineers aus mehr als 600 Unternehmen. KI-Coding erhöht den gelieferten Code um etwa 30 bis 40 %, doch das Beheben der eingebauten Bugs drückt den durchschnittlichen Netto-Produktivitätsgewinn auf etwa 15 bis 20 %. Der frühere Befund derselben Gruppe zu Ghost Engineers: Etwa 10 % der Engineers in ihrem damaligen Datensatz arbeiteten im Grunde gar nicht (Stanford 100k Developers Study (öffnet in einem neuen Tab)).
AEMM-Level in Videos aus dem Claude-Code-Ökosystem
- Level 1 (Ad-Hoc Adopter): einfaches Prompting, kein Kontextmanagement, einzelne Anfragen ohne Folgeschritt, Copy-Paste-Workflow
- Level 2 (Systematic Collaborator): CLAUDE.md, Slash-Commands, Workflow Explore-Plan-Execute, Prompts mit XML-Struktur, Bewusstsein fürs Kontextfenster
- Level 3 (Strategic Orchestrator): Context Priming, Hooks für Observability, Delegation an Subagents, Context Bundles, LSP-Integration, System Prompt Learning über Evals, der RPI-Workflow (Research-Plan-Implement)
- Level 4 (Autonomous Partner): Delegation an mehrere Agenten, Hintergrund-Agenten, eigene SDK-Agenten, Skills als Bausteine, Coding außerhalb der Schleife, Agent Experts mit selbstverbessernden Expertise-Dateien
- Level 5 (Code Multiplier): Template-Metaprompts, Agenten-Pipelines, eigene Domänen-Agenten, automatisierte Eval-Systeme, Meta-Agentics (Agenten bauen Agenten), “compute orchestrating compute”
12-Factor Agents: weitere Produktionsmuster (ganzer Talk)
Der vollständige Talk zu 12-Factor Agents ergänzt die Säulen oben um konkrete Muster für die Produktion. Jedes davon ordnen wir unten dem passenden AEMM-Level zu.
- Tool Use ist JSON plus Code, keine Magie (Einsicht für L2): “I’m going to go ahead and go on a limb here and say tool use is harmful. And I put it in quotes because I’m not talking about giving an agent access to the world… what is happening is our LLM is putting out JSON. We’re going to give that to some deterministic code that’s going to do something… There’s nothing special about tools. It’s just JSON and code.” Wer Tool Use entzaubert, macht den Schritt von L1 zu L2 (12-Factor Agents (öffnet in einem neuen Tab), AI Engineer, 3. Juli 2025).
- Micro Agents sind das Produktionsmuster (L2-L3): “Most production agents weren’t that agentic at all. They were mostly just software.” In Produktion funktioniert “a mostly deterministic DAG and you have these very small agent loops with like three to 10 steps.” Der zitierte Deploy-Bot läuft als deterministisches CI/CD, bis eine Entscheidung ansteht. Dann übernimmt eine kleine Agenten-Schleife und gibt danach an deterministischen Code zurück. “100 tools, 20 steps, easy. Manageable context, clear responsibilities” (12-Factor Agents).
- Pausieren und Fortsetzen durch Serialisieren des Zustands (L3-L4): “We’re going to allow our agent to call long-running tools. So we can interrupt the workflow, serialize that context window straight into a database because we own the context window… and then when we launch the workflow, eventually it’s going to call back with that state ID and the result. We use the state ID to load the state back out of the database… The agent doesn’t even know that things happened in the background.” Das ist die Fähigkeit für den Schritt von L3 zu L4: Agenten überdauern Sitzungen und setzen ohne Kontextverlust fort (12-Factor Agents).
- Die Grenze des Machbaren suchen (Assessment ab L3): “Find something that is right at the boundary of what the model can do reliably – like that it can’t get right all the time – and if you can figure out how to get it right reliably anyways because you’ve engineered reliability into your system, then you will have created something magical and you will have created something that’s better than what everybody else is building.” Das unterscheidet L3: Teams setzen Agenten nicht dort ein, wo sie mühelos gelingen. Sie konstruieren Verlässlichkeit an der Grenze des Machbaren (12-Factor Agents, mit einem Zitat des NotebookLM-Teams).
- Menschen per Tool kontaktieren, nicht per Output-Parsing (L3): “Almost everybody is avoiding this very important choice at the very beginning of output where you’re deciding between tool call and message to the human… if you can push that emphasis to a natural language token, you can give the model different ways. You can be ‘I’m done’ or ‘I need clarification’ or ‘I need to talk to a manager.’” Human-in-the-Loop ist eine vollwertige Fähigkeit des Agenten, kein Notausgang (12-Factor Agents).
The Elastic Loop: Agency als Wegbereiter im AEMM
Der Talk von INNOQ führt Agency als entscheidenden menschlichen Faktor für den Aufstieg durch die AEMM-Level ein. Gemeint ist die Fähigkeit, Autonomie auch zu nutzen.
- Enge der Schleife als Reifeindikator: Das Spektrum reicht von engen bis zu lockeren Schleifen. Enge Schleifen sind Autocomplete oder eine Kette kleiner Schritte, mit hoher kognitiver Last und maximaler Kontrolle. Lockere Schleifen sind asynchrone Delegation oder Ambient Agents, die auf Domain Events lauschen. Dort sinkt die kognitive Last, aber der Kontext muss vorab bereitliegen. “When stakes are high and the ambiguity are high… choose a tight loop. And when you’re able to provide the context on demand… the agent just listens in the background.” Engineers auf L1-L2 greifen standardmäßig zu engen Schleifen. Ab L3 wählen sie die Enge dynamisch nach Risiko und Qualität des Kontexts (The Elastic Loop: Context-Switching (öffnet in einem neuen Tab), INNOQ).
- Agency und Autonomie: “Not all people can deal with an overly big amount of autonomy. That’s where agency comes in. Agency is the ability to make use of autonomy. If your people are not agentic… they won’t use your autonomy. You can bury them in autonomy. They won’t embrace it.” Engineers mit hoher Agency sehen überproportionale Gewinne. Der “great divide” verläuft entlang der Agency, nicht nur entlang des Könnens. Agency ist ein menschlicher Faktor, den ein Reifegrad auf Basis von Skills nicht erfasst (The Elastic Loop).
- Kopfarbeit statt Handarbeit: “Don’t base your career on your hands work. Base it on your head’s work because the work you’re doing with your hands will get way cheaper.” Die Grundfähigkeit, die es zu entwickeln gilt: “provide judgment, high-level strategy, and handle the weird cases.” Das passt zur These des Knowledge Shift in Engineering-Philosophie. Es entspricht dem Weg von L1 (Coder) zu L4-L5 (Strateg:in) (The Elastic Loop).
- Vier strategische Fragen zur Wahl der Schleife: (1) Wie volatil ist das, woran ihr arbeitet? (2) Wie frisch ist der Kontext? (3) Wo liegt Vertrauen in eurer Organisation? (4) Welche Kennzahlen erkennen Drift in euren Schleifen? Diese Fragen entsprechen direkt Kriterien des AEMM-Assessments. Teams auf L1-L2 können sie nicht beantworten, Teams ab L3 kalibrieren damit ihre tägliche Arbeit (The Elastic Loop).
- Die Zeitachse von einem Jahrzehnt bestätigt den langsamen Aufstieg durch die Level: “The problems are tractable, they’re surmountable, but they’re still difficult. If I just average it out, it just feels like a decade to me.” Heutige Modelle sind “savant kids. They have perfect memory of all this stuff. They can convincingly create all kinds of slop that looks really good. But I still think they don’t really know what they’re doing.” Das stützt ein Prinzip des AEMM: Die meisten Enterprise-Teams liefern auf Level 3 enormen Wert und sollten nicht zu Level 5 hetzen (Why It’s the Decade of Agents (öffnet in einem neuen Tab)).
Welche externen Reifegradmodelle passen zum AEMM?
Zwei externe Modelle decken dasselbe Feld aus einem anderen Blickwinkel ab. Nutzt sie, um eine Level-Einstufung gegenzuprüfen, nicht als Ersatz dafür.
Das Dark-Factory-Modell (siehe Dark Factory Patterns):
| Dark-Factory-Konzept | AEMM-Entsprechung |
|---|---|
| Dark Factory | Level 5: Code Multiplier |
| Anti-Pattern Circus Ringmaster | Vibe Coding: Mensch als Bottleneck, kein Systemdesign |
| Codification Imperative | Context Engineering: Wissen ins System kodifizieren |
| Quality Inversion | Das Prinzip “Assure Speed By Quality” |
| Fitness Functions statt Specs | Zuerst TDD, “tests are the spec” |
| Narrator-Muster | Das Prinzip “Run Observable” |
| Citizen Development | Demokratisierung durch Struktur |
Lest die Zahlen genau. Das Dark-Factory-Modell stellt seine Ergebnisse als “100x productivity” dar. Pauschale Multiplikatoren halten einer echten Delivery-Pipeline nicht stand. Übernehmt die Muster und drückt Gewinne über die vier KPIs in Wirkung von Agentic Engineering messen aus.
Anthropics Reifegradmodell für Modernisierung hat vier Level (Anthropic - Code Modernization Playbook (öffnet in einem neuen Tab)):
| Modernisierungs-Level | Arbeitsdefinition | AEMM-Entsprechung |
|---|---|---|
| Ad hoc | Teams reagieren auf Ausfälle und Deadlines, Wissen und Validierung bleiben zersplittert. | Ad-Hoc Adopter |
| Planned | Finanzierte Projekte zielen auf benannte Systeme, aber Inventare und Praktiken bleiben auf das jeweilige Projekt beschränkt. | Systematic Collaborator |
| Systematic | Dafür abgestellte Teams nutzen gemeinsame Migrationsmuster, lebende Inventare, Tests und Ergebniskennzahlen. | Strategic Orchestrator |
| Optimized | Laufende Analysen schlagen Modernisierungsarbeit vor und validieren sie, unter expliziter menschlicher Governance. | Autonomous Partner |
Mit dieser Zuordnung führen ein Modernisierungsprogramm und ein AEMM-Assessment ein gemeinsames Gespräch über Reife, ohne die Modelle gleichzusetzen.
Ein Bewertungsraster mit zehn Dimensionen stuft jede Dimension einzeln ein, statt eine Organisation auf ein Level festzulegen. Jede Dimension hat acht Level:
- Denkweise
- Prompting
- Vertrauen zwischen Mensch und KI samt QA
- Heartbeat-Aufruf von Agenten
- Model Routing
- Absorption der Ausgaben
- Souveränität und Kontrolle über Modelle
- Parallelisierung
- Messung der KI-Wirkung
- Governance von KI-Rollouts
Das Raster ist eine kostenlose Selbstbewertung. Grundlage ist die Beratungsarbeit, die die Person dahinter seit 2022 leistet (AI Maturity Rubric (öffnet in einem neuen Tab)). Drei der Dimensionen haben keine Entsprechung im AEMM: die Absorption der Ausgaben, die Souveränität darüber, welche Modelle die Organisation kontrolliert, und die Governance eines Rollouts. Nutzt das Raster, wo ein Assessment auch Einkauf und Rechtsabteilung erreichen muss, nicht nur das Engineering. Für das Gespräch im Engineering bleibt das AEMM.
Verwandte Seiten
- Impact messen: wie ihr die Baseline aufsetzt, an der diese Evidenz gemessen wird.
- KI-Produktivitätsstudien: METR, Stanford, DORA, Multitudes: die Studien hinter den Zahlen in den Schlagzeilen.
- DX AI Impact Report: KI-gestützte Entwicklung im Benchmark: die oben zitierten Benchmark-Zahlen vollständig.
- Abschied von Agile: McKinseys Studie zum KI-Operating-Model: warum umgebaute Teams mehr erreichen als Tool-Rollouts.
- Qualitäts- und Produktivitätsmetriken: die Kennzahlen, die Output von Ergebnis trennen.
Quellen
Reifegradmodelle und Evidenz zur Einführung
- AI Maturity Rubric (öffnet in einem neuen Tab) - Kostenlose Selbstbewertung, die die KI-Einführung einer Organisation in zehn Dimensionen mit je acht Leveln bewertet, darunter Ausgaben, Souveränität und Governance.